前五篇建立了指标和设计。本篇把它们映射到真实代码、命令和产物,并用
stage2-20260824-final解释一次完整实验应该怎样复现、审计和转化为优化任务。
1. 第二阶段代码地图
第二阶段把“纯计算”和“有副作用的实验编排”分开:
benchmark/evaluation/   指标、协议、Gate、报告渲染
benchmark/scripts/      CLI、文件编排、数据库与模型调用
benchmark/schema/       问题 JSON Schema
benchmark/fixtures/     权限和生命周期隔离场景
benchmark/baselines/    Stage 1 冻结基线
benchmark/experiments/  每次实验的完整证据目录
evaluation 中的核心模块各自只回答一个问题:
| 模块 | 职责 |
|---|---|
questions.py | Schema 之外的语义校验和问题合并 |
manifest.py | 实验身份和外部请求预算 |
retrieval.py | 排名指标、聚合和逐题归因 |
threshold.py | 无答案混淆矩阵和模型独立阈值 |
context.py | Token 预算、证据保留、重复和来源 |
answer.py | 结构化事实、忠实度、相关性和引用 |
system.py | 权限、生命周期、延迟、Token 与成本 |
gates.py | 完整性与发布 Gate |
reporting.py | 确定性八段报告 |
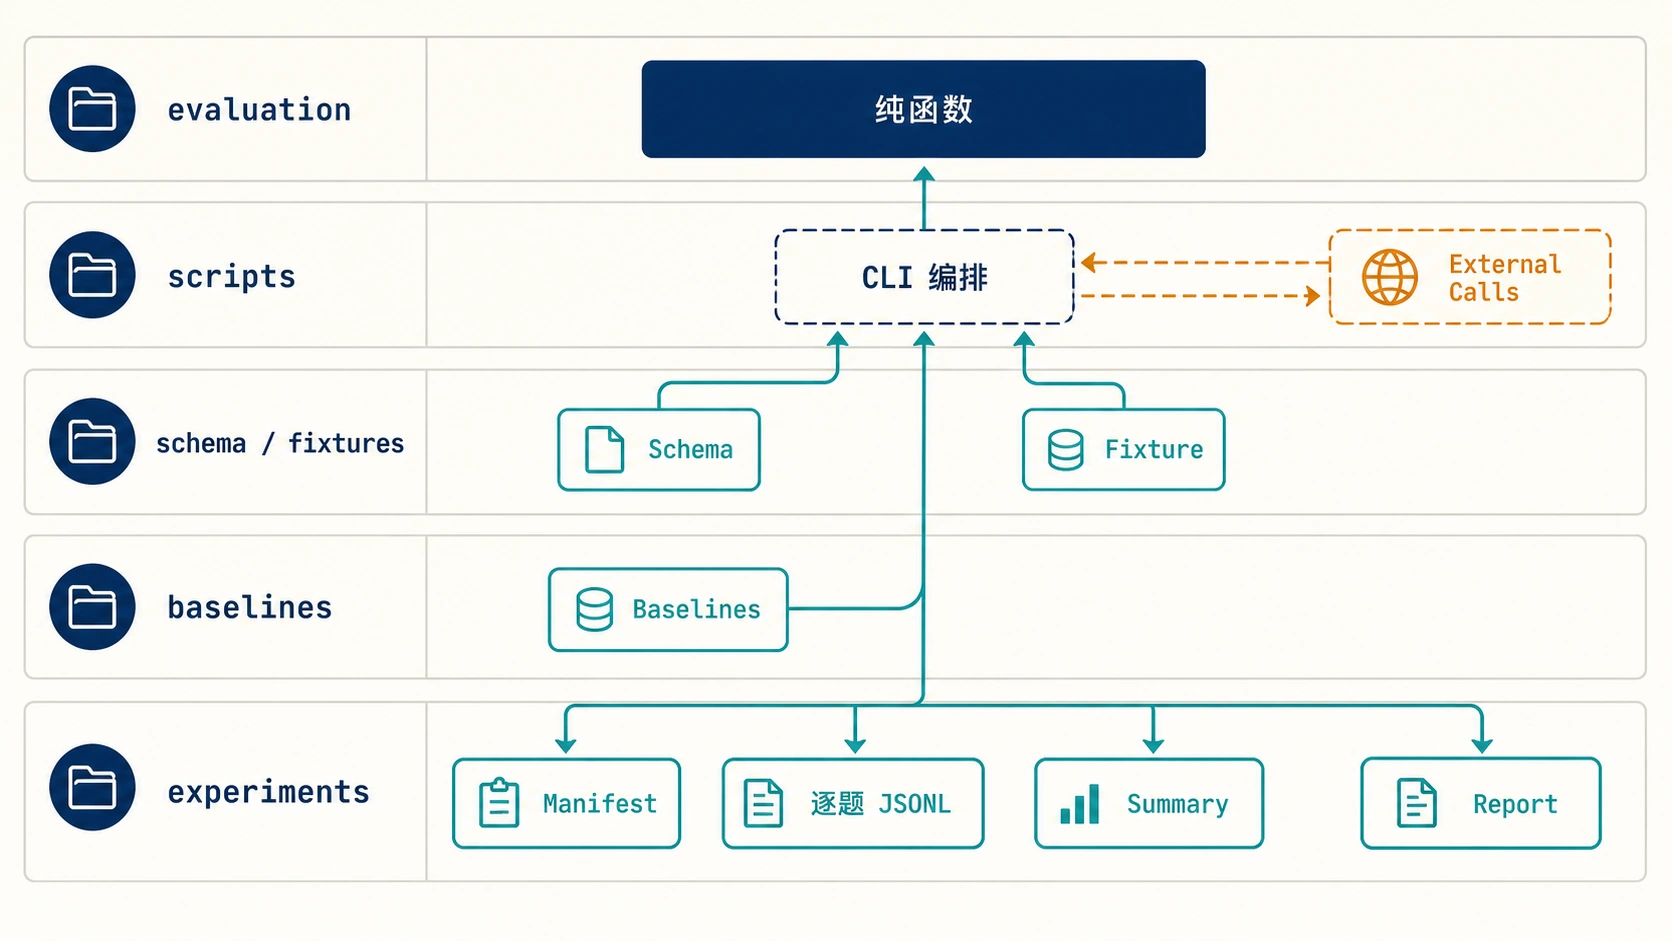
这条边界让指标函数可以用小型 fixture 单元测试,脚本则负责读写、断点和外部连接。定位错误时先判断是“计算口径错”还是“输入产物错”。
2. 准备问题集、语料和实验 Manifest
先校验问题集:
python3 -m benchmark.scripts.validate_questions脚本读取分类型 questions_*.jsonl,完成 Schema 和语义校验后才原子生成 benchmark/questions.jsonl 与 dataset_validation.json。错误会带问题 ID 汇总返回,不会遇到第一条就停止。
为正式运行创建独立实验目录:
python3 -m benchmark.scripts.prepare_experiment stage2-learning-run \
  --request-limit 500 \
  --already-used 2
Manifest 会记录实验 ID、Git Commit、Snapshot、模型、Top K、距离、输入路径和请求账本。正式 A/B 前还要确保:
- 两个模型使用同一份冻结 Chunk;
- 两边维度都为 1024;
- Query Vector 只能搜索本模型的 Corpus;
- 精确 cosine 检索、保存 Top 10;
- 不把两个模型的 similarity 绝对值直接比较。
需要重新生成语料 Embedding 时,应先运行准备与嵌入脚本;复现归档实验时,则优先使用已经保存的 corpus_chunks.jsonl、Snapshot 和逐题结果,避免不必要的外部调用。
3. 运行检索、阈值、Context 与回答评测
以下顺序体现依赖关系,而不是任意命令清单。用变量表示实验目录:
EXPERIMENT_DIR=benchmark/experiments/stage2-learning-run

# 两个模型分别生成 Query Embedding,并搜索各自 Corpus
python3 -m benchmark.scripts.run both \
  --experiment-dir "$EXPERIMENT_DIR"

# 从逐题 Top 10 计算检索指标、Pairwise 和归因
python3 -m benchmark.scripts.evaluate \
  --experiment-dir "$EXPERIMENT_DIR"

# 在开发集选阈值,再固定到 Holdout
python3 -m benchmark.scripts.calibrate_threshold \
  --experiment-dir "$EXPERIMENT_DIR"

# 构造确定性 Context 能力上限,不调用在线 LLM
python3 -m benchmark.scripts.run_answers \
  --experiment-dir "$EXPERIMENT_DIR" \
  --mode deterministic_context_ceiling

# 评价结构化事实、忠实度、相关性和引用
python3 -m benchmark.scripts.evaluate_answers \
  --experiment-dir "$EXPERIMENT_DIR"

# 使用隔离 fixture 评价权限、生命周期、延迟与用量
python3 -m benchmark.scripts.performance \
  --experiment-dir "$EXPERIMENT_DIR" \
  --permission-cases benchmark/fixtures/permission_cases.json \
  --lifecycle-events benchmark/fixtures/lifecycle_events.json

# 汇集证据并判定双状态 Gate
python3 -m benchmark.scripts.report \
  --experiment-dir "$EXPERIMENT_DIR"
生产只读审计需要显式加 --inspect-production-read-only,只检查 Schema 和索引状态,不修改生产对象。在线答案采集也必须显式改为 online_capture,指定固定题目并受 Manifest 请求预算约束;默认流程不会偷偷调用 LLM。
4. 理解统一实验产物
一个实验目录不是“一个报告”,而是一条证据链:
| 产物 | 回答的问题 |
|---|---|
manifest.json | 用什么代码、数据、模型和预算运行? |
results_*.jsonl | 每题实际召回了哪些 Chunk? |
retrieval_per_query.jsonl | 每题 Hit、Recall、MRR 和失败类型是什么? |
retrieval_metrics.json | 总体与分类指标如何聚合? |
threshold_samples.jsonl | 每个阈值候选的混淆矩阵是什么? |
thresholds.json | 开发集选了什么阈值,Holdout 表现怎样? |
answer_results.jsonl | 最终 Context、结构化答案和耗时是什么? |
answer_per_query.jsonl | 每题 Context、回答和引用得分是什么? |
system_summary.json | 权限、生命周期、延迟与成本怎样? |
summary.json | 机器可读统一结论是什么? |
REPORT.md | 人类怎样阅读全部证据? |
报告中的均值只能作为入口。真正调试时要回到逐题 JSONL,查看问题、Gold、Top K、Context、Fact 和错误标签。如果某项汇总异常却无法追到具体题目,评测体系仍不具备诊断能力。
5. 解读第二阶段真实实验结果
最终实验的边界是:
35 documents / 1165 chunks
136 questions = 116 answerable + 20 no-answer
4 disputed frozen questions excluded from formal quality metrics
text-embedding-v4 vs qwen3.7-text-embedding
1024 dimensions / exact cosine / Top 10 saved
LLM-as-Judge disabled / online answer requests 0
正式 112 道可回答检索题的总体结果:
| 指标 | v4 | qwen3.7 |
|---|---|---|
| Hit@1 | 0.6875 | 0.7946 |
| Hit@5 | 0.9554 | 0.9911 |
| Recall@5 | 0.9263 | 0.9606 |
| MRR | 0.8142 | 0.8899 |
| Fact Complete@5 | 0.9018 | 0.9286 |
Pairwise 为 qwen3.7 胜 22、v4 胜 10、80 题打平。质量 Gate 没有发现超过容忍度的 Stage 1 同题回归。
回答侧的 Correctness 0.9886、Faithfulness 0.9924、引用 Precision/Recall 均为 1,但这些是确定性 Context 上限。Context Precision 只有 0.1267,说明候选上下文仍有明显去噪空间。nDCG 由于相关性池未覆盖两个模型 Top 5 并集,只能作为实验观察。
系统侧发现权限字段和版本能力缺失,因此最终结论是“评测体系完整,当前 RAG 不可发布”。这比一个单独的 0.95 分更有价值,因为它明确告诉团队下一步应先修什么。
6. 从失败案例进入第三阶段
第二阶段建立尺子,第三阶段使用尺子解决问题。每个优化 Issue 应遵循:
归档失败证据
→ 写能稳定复现的专项评测
→ 只改变一个候选方案
→ 运行局部测试和完整回归
→ 检查质量、安全、性能与成本
→ 通过后并回永久问题集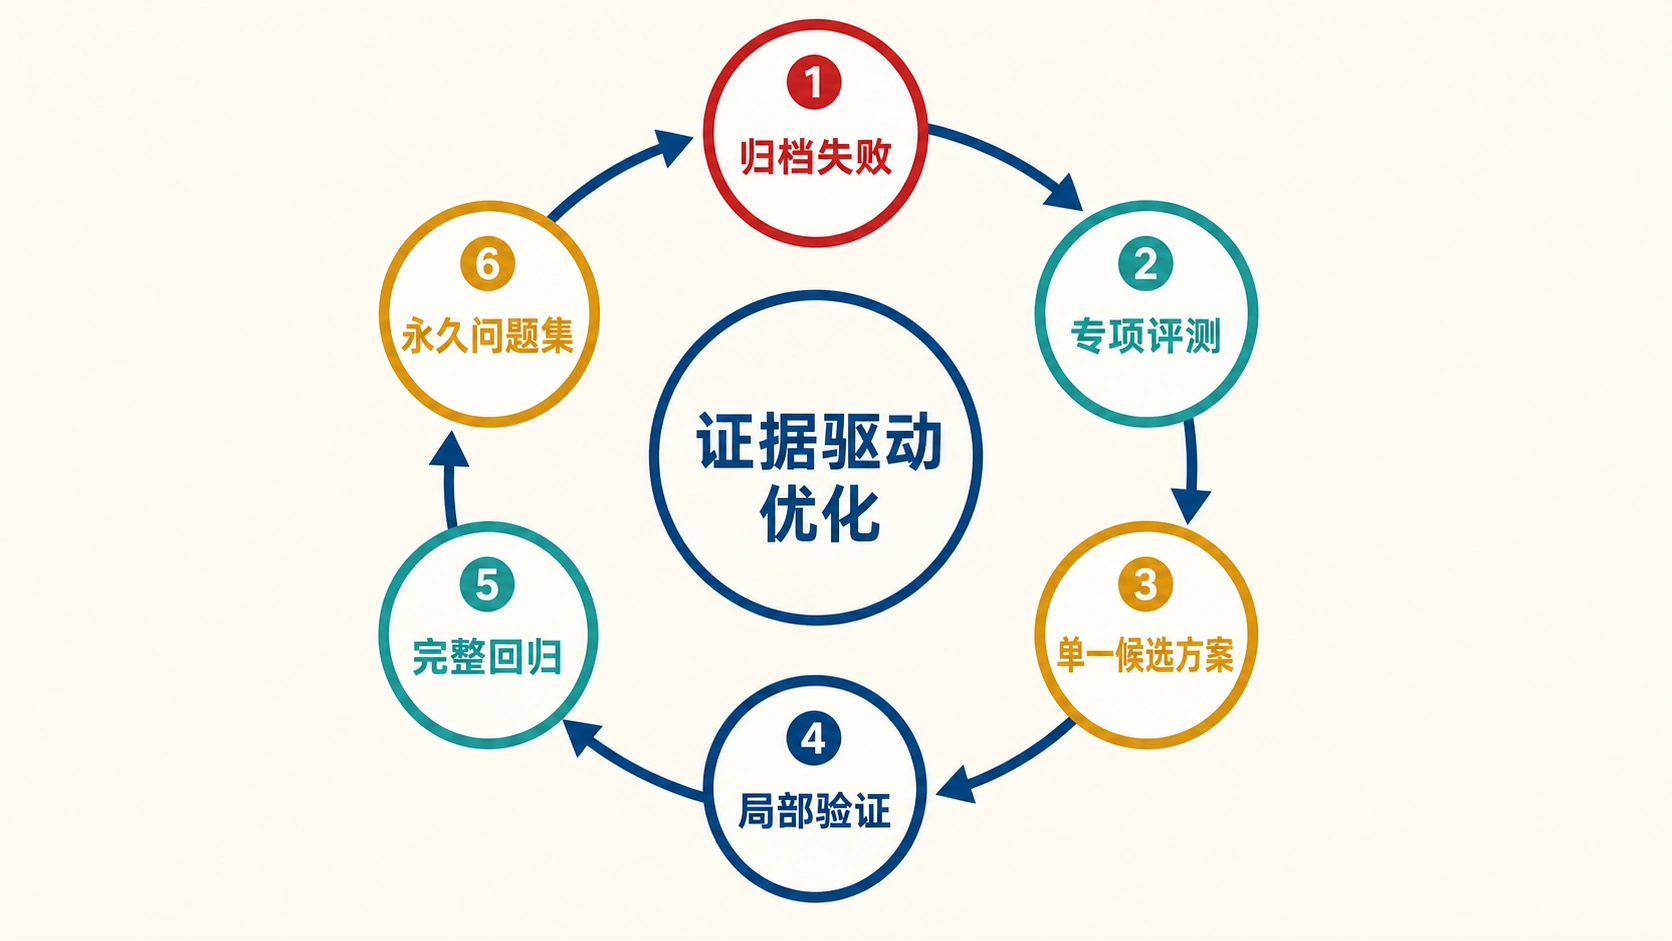
建议动手实验
- 手算一个包含两个 Gold 的 Hit@5、Recall@5、Precision@5 和 MRR;
- 修改 Top K,观察 Recall 与 Precision 的拉扯;
- 构造一个无答案硬负例,画出两个阈值下的混淆矩阵;
- 把关键 Gold 排到 Token 预算之后,观察检索与 Context 指标如何分离;
- 给无权主体返回一个高相似私有 Chunk,确认安全 Gate 是否立即失败;
- 删除一个文件但保留索引记录,观察生命周期报告;
- 删除实验目录中的一个必需产物,确认完整性 Gate 不会默认通过;
- 从一条真实退步题创建第三阶段 Issue,并写明基线、候选方案和验收门槛。
自测题
- 为什么 Hit@5 高不能证明多证据问题完整?
- 为什么不同模型不能共用拒答阈值?
- 检索 Recall 高、Context Recall 低时应该先改哪一层?
- Correctness 和 Faithfulness 为什么可能不同?
- 为什么权限泄漏不能被高平均分抵消?
- 为什么确定性回答 0.99 不能宣传为真实 LLM 准确率?
evaluation_system_complete=true与rag_release_gate_passed=false为什么不矛盾?- 为什么新的专项题最终必须并回完整回归体系?
能用真实产物回答这些问题,就已经从“会运行 Benchmark”迈向“能使用证据改进 RAG”。
阶段三实施路线:阶段三:基于问题诊断的 RAG 优化