Retriever 总会返回“最相似”的内容,但最相似不等于足以回答。本篇先建立无答案决策,再检查 Top K 进入 LLM 之前是否丢失、重复或污染了证据。
1. 为什么 RAG 必须学会说不知道
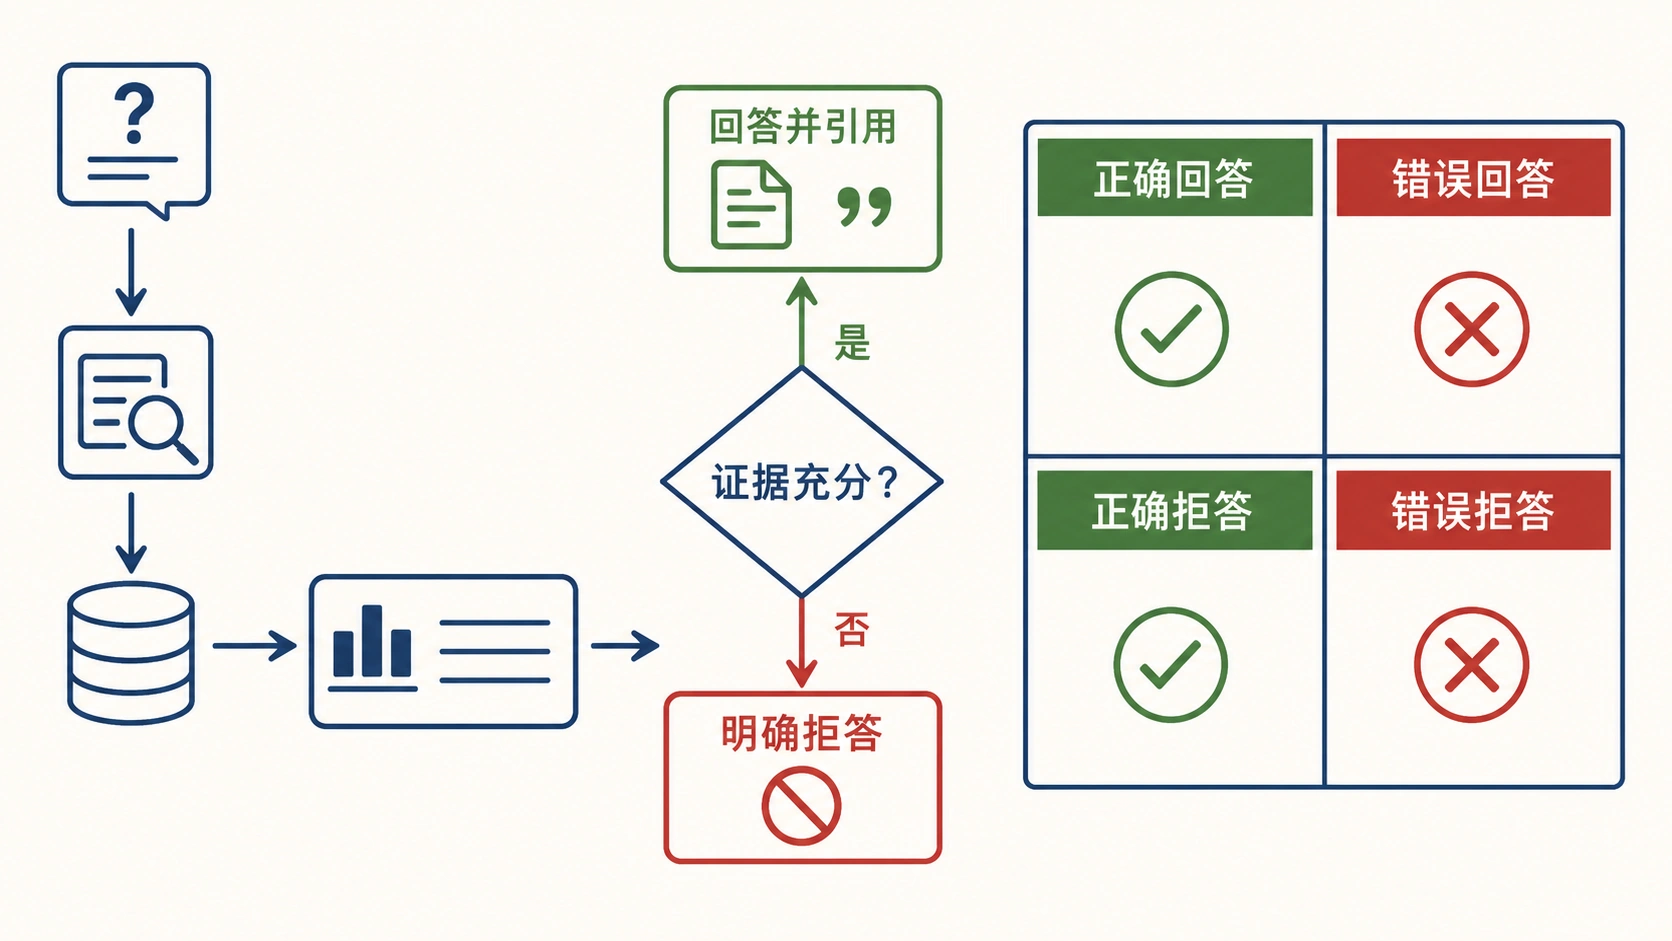
向量检索不会自然返回“没有结果”。即使知识库完全不包含某项配置,数据库仍能找出距离最近的若干 Chunk。如果系统把“有 Top 1”误当作“有答案”,LLM 就会在相似主题上继续补全。
无答案评测至少需要三类问题:
- 明确缺失:冻结语料没有相关产品或版本;
- 硬负例:语料有相似概念,但缺少问题要求的那个事实;
- 边界问题:语料只回答一部分,完整回答仍不成立。
每道无答案题都要写 unanswerable_reason,说明为什么能从冻结语料确定它不可回答。不能仅因为当前模型没有找到就把题标成无答案,否则检索失败会被误写成 Gold。
2. 混淆矩阵与拒答 Precision、Recall、F1
本项目把“系统决定回答”视为正类,分数大于等于阈值就回答:
| 真实情况 | 系统回答 | 系统拒答 |
|---|---|---|
| 可回答 | TP:正确接受 | FN:错误拒答 |
| 无答案 | FP:错误接受 | TN:正确拒答 |
回答侧指标是:
Answer Precision = TP / (TP + FP)
Answer Recall    = TP / (TP + FN)
拒答侧则换一个观察角度:
Refusal Precision = TN / (TN + FN)
Refusal Recall    = TN / (TN + FP)
Refusal F1        = 2PR / (P + R)
拒答 Recall 低,表示许多无答案问题被放行,容易产生幻觉;拒答 Precision 低,表示大量本可回答的问题也被拒绝,系统过于保守。
本项目选择阈值时把错误接受 FP 的权重设为 2,因为“无依据地回答”比“谨慎拒答一次”风险更高。但权重是产品策略,不是通用常数。医疗、法律或内部机密问答可能需要更高权重,创意搜索则可能更重视召回。
3. 为什么拒答阈值必须按模型校准
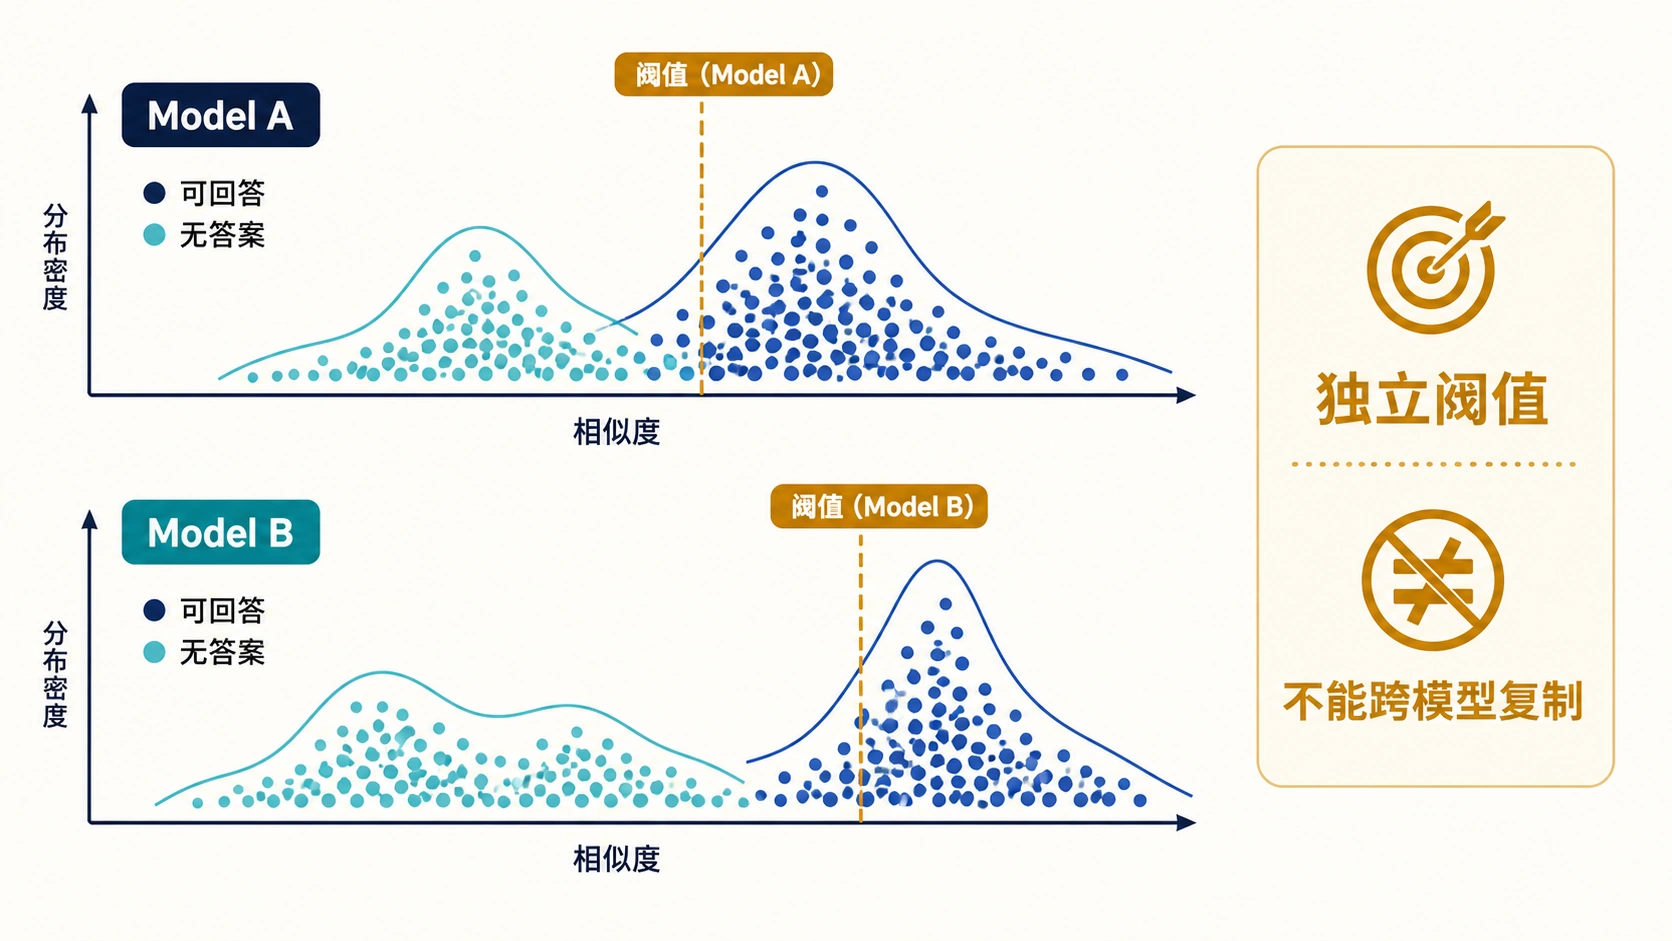
不同 Embedding 模型的向量空间和相似度分布不同。同样是 0.75,在一个模型里可能是强相关,在另一个模型里只是普通近邻。因此阈值必须绑定:
模型 + 维度 + Snapshot + 开发集哈希校准流程是:
- 在开发集收集每题 Top 1 分数和 Answerable 标签;
- 扫描所有候选决策边界;
- 计算混淆矩阵与加权错误;
- 先最小化加权错误,再用 F1 和更高阈值打破平局;
- 固定阈值后只在 Holdout 上评估,不能继续调参;
- 模型、维度、语料或开发集变化时拒绝复用旧阈值。
最终实验中:
| 模型 | 开发集阈值 | Holdout 回答 F1 | Holdout 拒答 F1 |
|---|---|---|---|
| text-embedding-v4 | 0.7825 | 0.6667 | 0.6154 |
| qwen3.7-text-embedding | 0.6776 | 0.9000 | 0.7500 |
这组结果说明两件事:阈值确实不能跨模型复制;v4 的开发集阈值在 Holdout 上错误拒绝了较多可回答问题,不能只报告开发集的漂亮分数。
4. 检索结果为什么不等于最终 Context
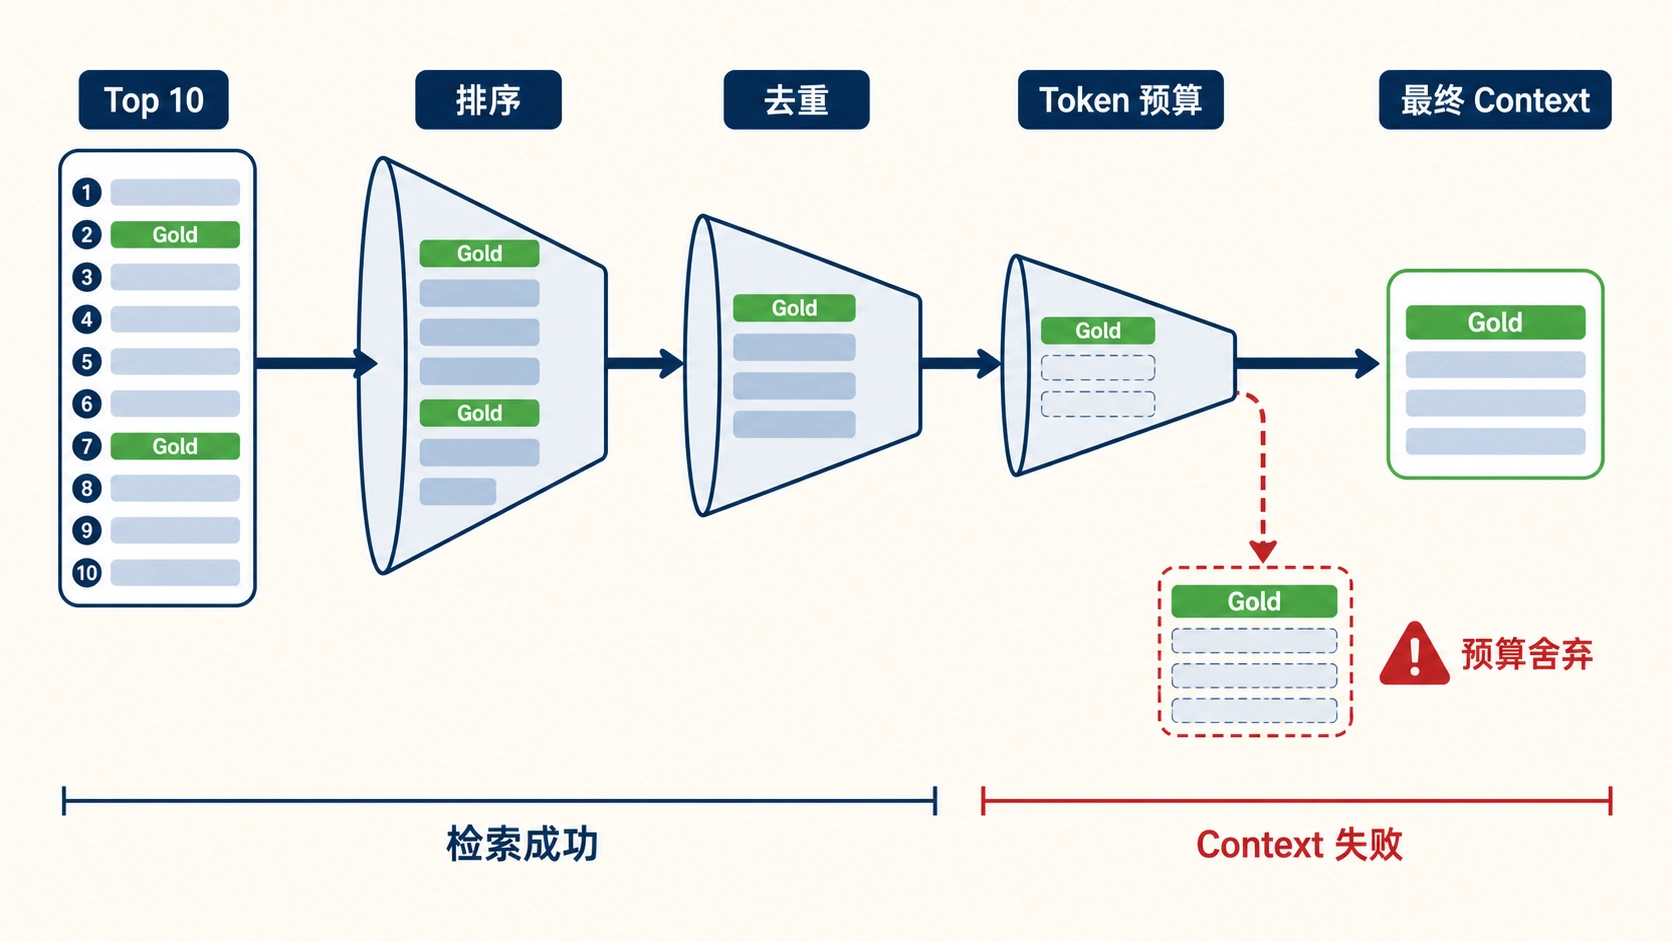
完整链路不是 Top K = Context。Context Builder 还可能执行:
- 按排名重新组织;
- 去掉重复 Chunk;
- 拼接标题、来源和正文;
- 按 Token 预算选择内容;
- 舍弃超过预算的 Chunk;
- 为引用保留 provenance。
因此需要同时保存“Retriever 返回了什么”和“LLM 最终看到了什么”。如果 Gold 在 Top 10,却没进入 Context,检索指标应通过而 Context 指标应失败,根因才能被正确定位。
本项目的 build_context 使用确定性 Token 近似器,按检索顺序选择完整 Chunk。一个 Chunk 放不下时整块舍弃,不截断正文。这样做不一定是最终最佳策略,但它可重复,且不会把半段证据伪装成完整内容。
5. Context Recall 与 Context Precision
Context Recall:必要证据有多少仍然可见
Context Recall = Context 中可见的必要证据 / 全部必要证据它验证 Token 预算、排序和去重是否丢掉答案所需内容。检索 Recall 高而 Context Recall 低,应该先修 Context Builder,而不是换 Embedding。
Context Precision:最终上下文有多少真正相关
Context Precision = Context 中的相关内容 / Context 全部内容严格实现可以按 Chunk、事实或 Token 计算,但必须在报告中说明口径。本项目根据 Gold/Fact 支持关系评估已选 Chunk 的证据密度。
最终确定性上限实验中,Context Recall 为 0.9866,Context Precision 只有 0.1267。这表示必要事实几乎都被保留,但 Context 仍带入大量非严格 Gold 内容。下一阶段可以研究 Reranker、动态 K 或压缩,但不能从低 Precision 直接断言所有非 Gold Chunk 都无用,因为 Gold 池本身也可能不完备。
6. 重复率、预算利用率、顺序与来源完整性
只看 Recall 和 Precision 仍不够。
Redundancy Ratio
相邻重叠 Chunk 可能重复同一段文字,浪费窗口并放大局部证据。本项目用同源相邻 Chunk 的后缀/前缀完全重叠 Token 估计重复率。
Budget Utilization
Budget Utilization = 已使用 Token / Token 预算利用率太低可能表示“整块舍弃”留下大空洞;接近 1 也不代表好,因为内容可能全是噪声。它必须和 Recall、Precision 一起解释。
顺序与来源完整性
相关证据排得太后,会增加截断风险;丢失 chunk_id、source_path 或 heading,则后续无法生成可验证引用。因此 Context Artifact 必须保存已选 Chunk、舍弃 Chunk、顺序、预算和 provenance。
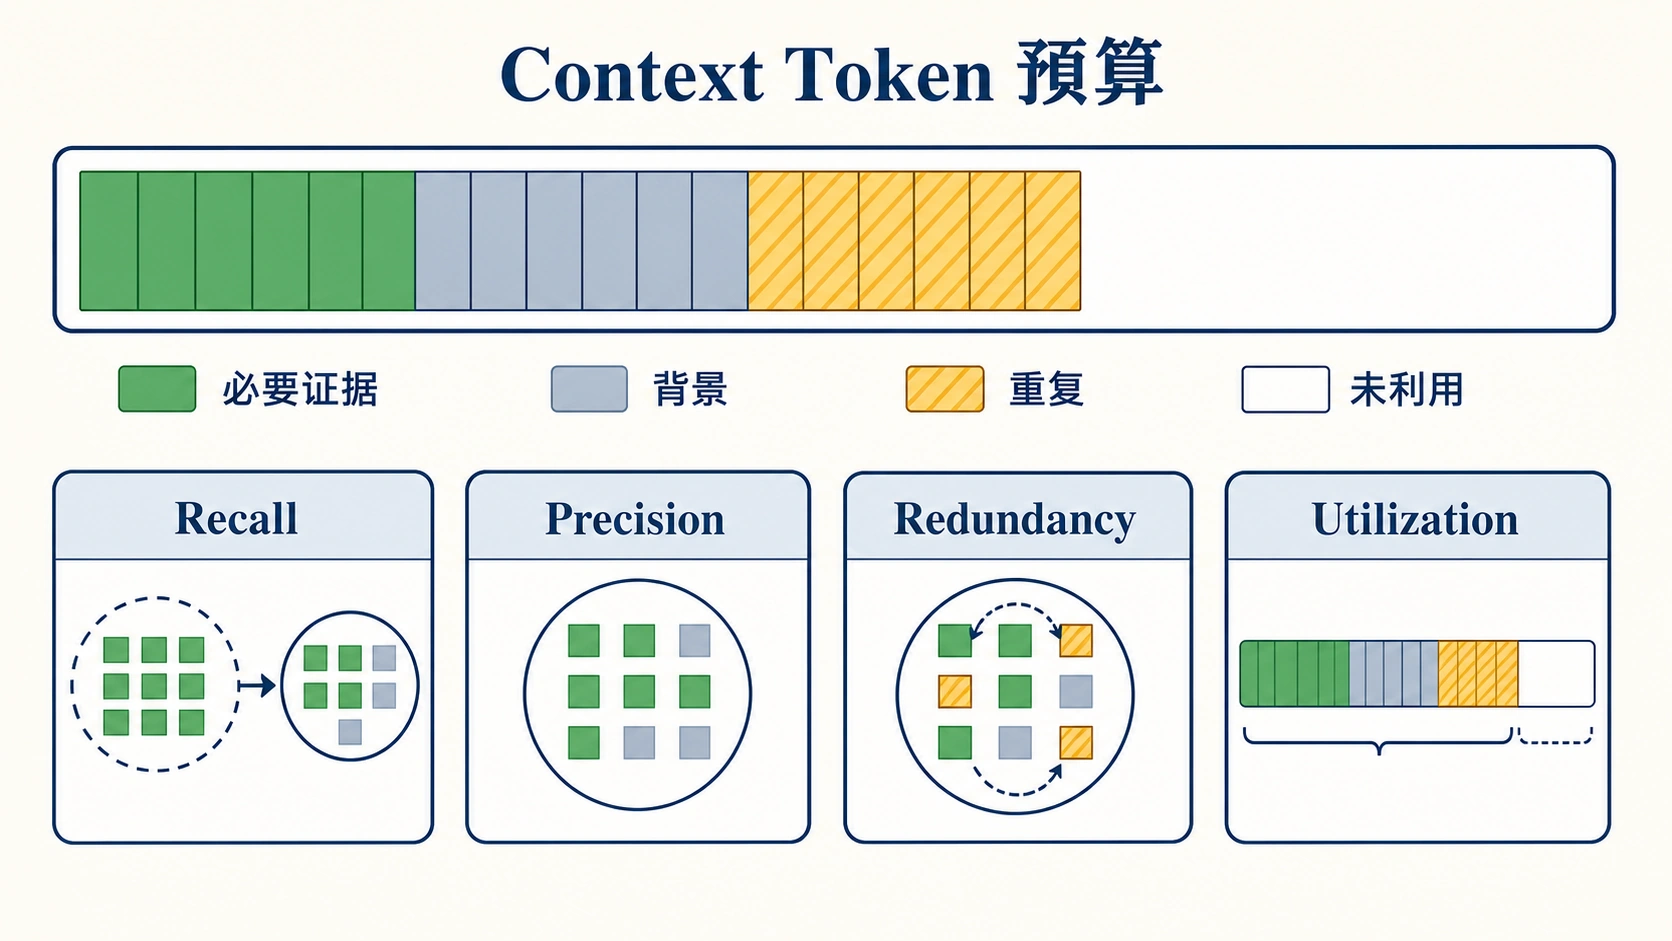
最终实验的预算利用率为 0.4845、provenance 完整率为 1、证据截断数为 0。这里的正确结论是“当前确定性拼装保留了几乎全部必要事实且来源完整”,而不是“真实线上回答已经接近满分”。下一篇会解释这个边界。