面向第一次接触 RAG 的读者。本篇先建立“它为什么存在、每个名词是什么意思、 数据到底怎样流动”的整体概念,不要求你预先了解向量数据库或大模型框架。
1. 学完本篇,你应该能回答什么
- RAG 与直接向 LLM 提问有什么不同?
- 为什么要把 Markdown 拆成 Chunk,而不是把整篇文章都塞进 Prompt?
- Embedding、向量、向量空间、维度分别是什么?
- pgvector 在系统中负责什么,又不负责什么?
- 为什么数据库必须同时保存原文和向量?
- Top K、Context、Prompt 和最终答案之间是什么关系?
- 为什么 RAG 有了知识库仍然可能答错?
如果读完后只能记住一句话,请记住:
RAG 不是让 LLM 记住知识,而是在回答前先替它找到资料,再把资料放进本轮 Prompt。
2. RAG 是什么
RAG 是 Retrieval-Augmented Generation 的缩写,通常翻译为“检索增强生成”。
把这个名称拆开看:
- Retrieval(检索):从外部知识库中寻找与问题相关的文本。
- Augmented(增强):把找到的文本作为额外上下文交给模型。
- Generation(生成):LLM 根据问题和上下文组织最终答案。
它解决的核心问题是:LLM 的内部知识可能过时、不包含你的私有文档,也不能天然知道 你刚发布的 Markdown。RAG 让模型在回答前临时“翻资料”。
一个生活化类比:
直接问 LLM:闭卷考试,模型只能依靠训练时记住的内容。
RAG:开卷考试,先由检索器从指定资料中找出相关页,再让模型组织答案。
“开卷”并不保证满分。如果检索器拿错了页,或者资料本身没有答案,LLM 仍可能回答不好。
3. 一张图看懂完整链路
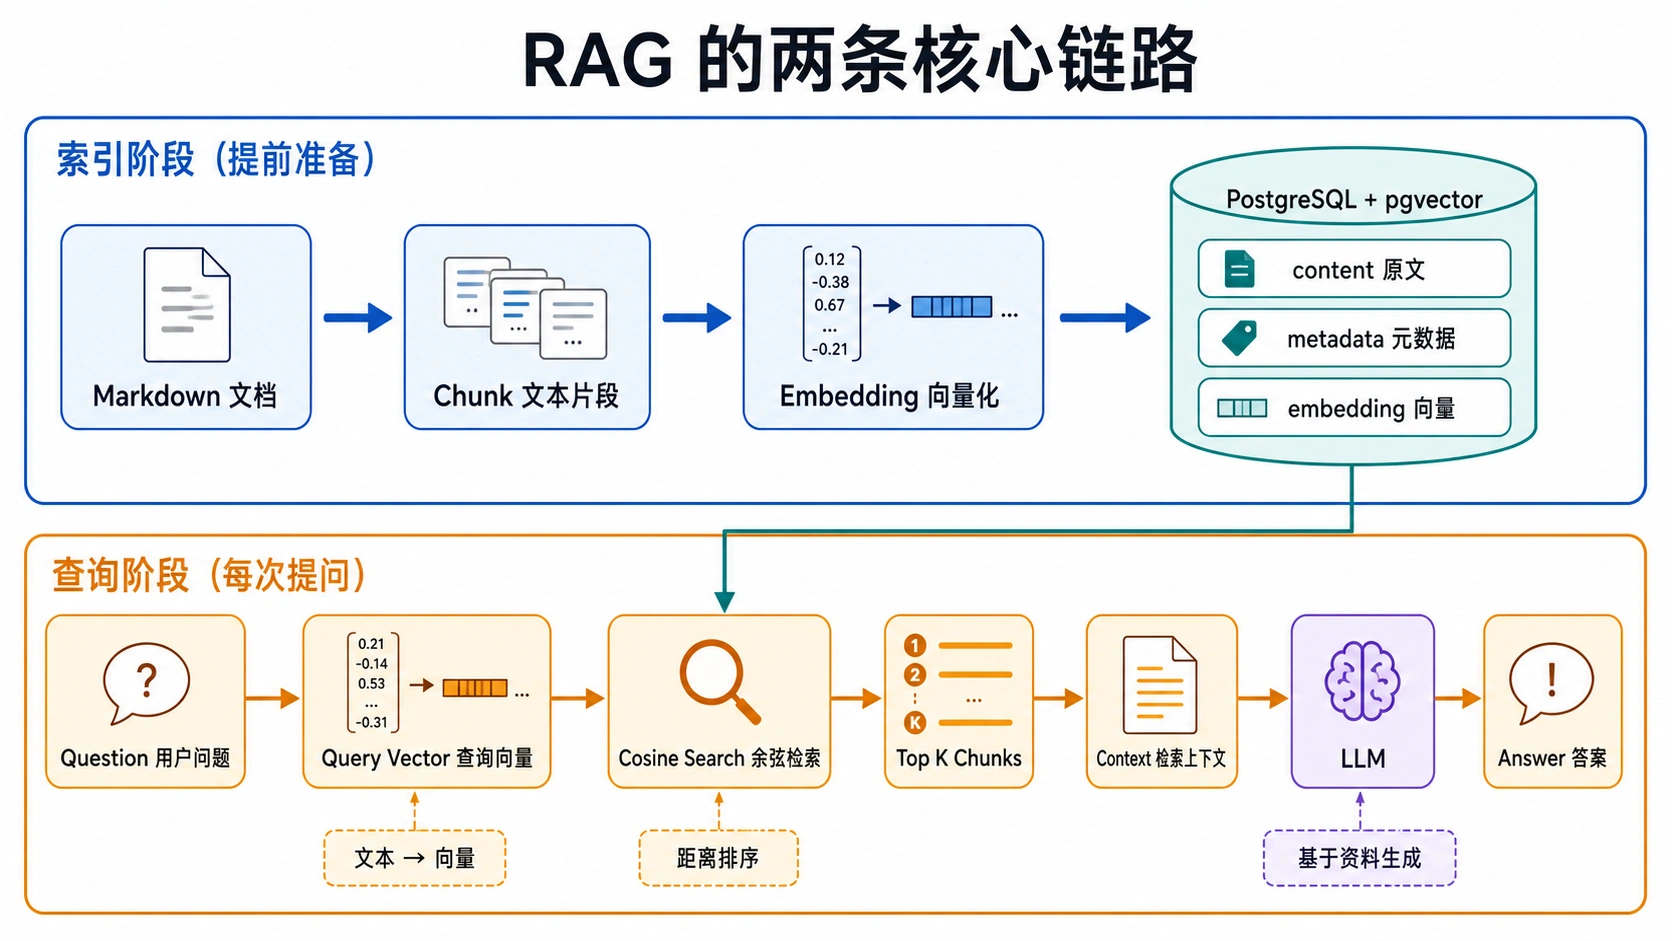
这张图包含两条相互配合但执行时机不同的链路:
3.1 索引链路:提前准备可搜索的知识
Markdown
  → 解析文档和元数据
  → 按标题与长度切成 Chunk
  → 每个 Chunk 生成 Embedding
  → 原文、元数据、向量一起写入 PostgreSQL + pgvector
索引不是用户每提问一次就重做。通常在文章新增或修改后运行一次。
3.2 查询链路:每次提问时寻找资料并回答
Question
  → 使用同一个 Embedding 模型生成查询向量
  → pgvector 计算查询向量与已有 Chunk 向量的距离
  → 取最接近的 Top K Chunk
  → 拼成 Context
  → LLM 根据 Context 与 Question 生成 Answer
两条链路必须使用兼容的向量空间。若知识库用模型 A 生成向量,问题却用模型 B 生成向量, 两边的坐标含义不同,距离不再有可靠意义。
4. 核心名词词典
4.1 Knowledge Base / Corpus:知识库与语料
定义:可供系统检索的全部原始资料集合。评测语境中常称为 Corpus(语料库)。
本项目中的位置:默认是 knowledge/ 下的 Markdown;生产部署可以通过
KNOWLEDGE_DIR 指向博客文章目录。
常见误区:把知识库理解成“模型已经学会的内容”。实际上文档仍在外部存储, LLM 只会在一次请求中看到被检索出来的少量片段。
4.2 Document:文档
定义:知识库中的一篇完整资料,例如一篇 Markdown 博客。
本项目中的位置:documents 表一行对应一篇文档,保存路径、标题和内容哈希。
为什么需要:它保留来源边界。最终答案可以告诉用户证据来自哪篇文章,文档更新时也能 只重建受影响的 Chunk。
4.3 Chunk:文本片段
定义:从完整文档中切出的、可独立检索的一小段文字。
为什么需要:整篇文章可能包含很多主题。若只为整篇文章生成一个向量,不相关内容会 稀释真正相关的段落;若片段过小,又可能丢失回答问题所需的上下文。
生活化类比:检索一本书时,我们希望定位到“某一节或某几页”,而不是只知道答案可能在 整本书里。
本项目中的位置:document_chunks 表一行对应一个 Chunk。
常见误区:Chunk 越小越精确。过小的 Chunk 可能只剩一个结论,没有适用条件、原因或例子。
4.4 Chunk Size:片段大小
定义:一个 Chunk 最多容纳多少内容。本项目 v0.1 使用字符数近似衡量,默认 1200。
它是“召回粒度”和“上下文完整性”之间的折中:
- 太大:一个向量混合多个意思,检索不够聚焦,交给 LLM 的无关文本也更多。
- 太小:语义不完整,同一个答案可能散落在多个片段里。
它不是脱离数据集就能确定的万能常数,需要通过真实问题评测。
4.5 Chunk Overlap:片段重叠
定义:按长度连续切块时,相邻 Chunk 重复保留的字符数。本项目默认 200。
为什么需要:一句话或一个代码示例可能刚好跨越切分边界。Overlap 为边界两侧保留一些 共同上下文,降低信息被“切断”的概率。
代价:重叠越多,需要向量化和存储的重复文本越多,也可能返回高度重复的结果。
4.6 Embedding:文本向量化
定义:Embedding 模型把一段文本映射为一组固定长度的数字。
"RedisCacheManager 如何设置 TTL?"
        ↓ Embedding Model
[0.018, -0.073, 0.221, ... 共 1024 个数]
这组数字不是加密后的文本,也不能反向还原成原句。它的用途是让语义接近的文本在同一个 向量空间里距离更近。
本项目中的位置:src/embedding.py 调用 Embedding API;数据库中的
embedding VECTOR(1024) 保存结果。
常见误区:Embedding 模型会回答问题。它只负责把文本变成向量,不生成自然语言答案。
4.7 Vector:向量
定义:按固定顺序排列的一组数字。可以把它想象成文本在高维坐标系中的位置。
二维坐标 (3, 5) 表示平面上的一个点;1024 维向量也是一个点,只是人类无法直接画出全部
维度。我们不必解释“第 347 维具体表示什么”,只需利用不同点之间的距离关系。
4.8 Dimension:维度
定义:一个向量包含多少个数。本项目使用 1024 维。
维度必须贯穿整个系统保持一致:
Embedding API 返回 1024 维
        ↕ 必须一致
PostgreSQL 列定义 VECTOR(1024)
维度更高不自动代表效果更好。它还会增加存储、网络传输和计算成本。
4.9 Vector Space:向量空间
定义:某个 Embedding 模型建立的坐标体系,以及文本在这个体系中的位置关系。
不同模型即使都输出 1024 维,也不代表坐标含义相同。可以把它类比为两张使用不同原点和比例尺
的地图:两张图上都写着 (100, 200),却可能对应完全不同的地点。
因此换 Embedding 模型后通常需要重新生成知识库向量。
4.10 pgvector
定义:PostgreSQL 的向量扩展,使数据库能够保存向量并计算向量距离。
本项目中的职责:
- 保存
VECTOR(1024); - 计算查询向量与 Chunk 向量的余弦距离;
- 按距离排序并返回 Top K。
它不负责:解析 Markdown、切块、生成向量、理解自然语言或生成答案。
4.11 Cosine Distance / Cosine Similarity:余弦距离与相似度
余弦方法关注两个向量“方向是否接近”,而不是长度是否相同。
- pgvector 的
<=>返回 cosine distance(余弦距离),越小越接近。 - 本项目展示
1 - cosine_distance作为 cosine similarity(余弦相似度),越大越接近。
ORDER BY embedding <=> query_vector  -- 距离从小到大,最近的排前面

1 - (embedding <=> query_vector)     -- 转成便于阅读的相似度
这里的相似度只是排序信号,不是“答案正确率 83%”,也不是模型的置信度。
4.12 Exact Search 与 ANN
**Exact Search(精确搜索)**会比较所有候选向量,确保找出真实最近邻。
**ANN(Approximate Nearest Neighbor,近似最近邻)**使用 HNSW、IVFFlat 等索引, 以可能漏掉少量正确结果为代价换取更高速度。
本项目数据量较小,故意不建立 ANN 索引,先消除索引参数带来的额外变量,直观看清向量检索本身。
4.13 Top K
定义:检索阶段最多返回排名最靠前的 K 个 Chunk。本项目默认 TOP_K=5。
- K 太小:可能遗漏回答所需资料。
- K 太大:无关内容、重复片段和 Prompt Token 增加,可能干扰 LLM。
Top K 不是越大越好,它同样需要通过评测选择。
4.14 Context:检索上下文
定义:本轮检索得到并实际放入 Prompt 的资料片段。
它不是模型的全部上下文窗口,也不是整个知识库。模型本轮只能看到被放入 Context 的内容。
4.15 Prompt
定义:一次发送给 LLM 的完整输入。本项目由两部分消息组成:
- System Prompt:规定角色和边界,例如只依据知识库回答、资料不足时明确说明。
- User Message:包含检索 Context 和用户 Question。
Prompt 是“给模型的试卷与参考资料”,而 Embedding 向量不会直接放进 Prompt。
4.16 LLM
定义:Large Language Model,大语言模型。本项目使用 OpenAI 兼容聊天接口。
职责:阅读自然语言 Context,根据问题归纳、解释和组织答案。
不负责:在数据库中进行向量排序。Retriever 与 LLM 是两个不同阶段。
4.17 Hallucination:幻觉
定义:模型生成了听起来合理、但资料并不支持或事实不正确的内容。
RAG 可以通过提供证据降低幻觉,却不能从机制上完全消灭它,原因包括:
- 检索器召回了错误片段;
- 正确片段未进入 Top K;
- 知识库本身错误或过时;
- Prompt 约束不足;
- LLM 没有忠实使用 Context。
因此生产 RAG 需要同时评测检索和生成,而本项目第一步先把检索过程看清楚。
5. 用一个具体问题走完整链路
假设知识库中有片段:
Title: Spring Cache 学习笔记

Section: Spring Cache > RedisCacheManager > TTL

RedisCacheManager 可以通过 RedisCacheConfiguration.entryTtl 配置过期时间。
用户提问:
Spring Cache 中的缓存多久会失效?执行过程:
- 问题被 Embedding 模型转换为查询向量。
- pgvector 将查询向量与所有 Chunk 向量计算余弦距离。
- 虽然问题没有直接出现
TTL,语义接近的片段仍可能排到前面。 - 系统从数据库取回片段的
content,而不是尝试把向量还原为文本。 - 文件、章节和正文被组装为 Context。
- LLM 根据 Context 生成“可通过
entryTtl配置过期时间”等自然语言答案。
这个例子体现了 Dense Retrieval 的价值:它可以处理改写和同义表达。但对错误码、类名、命令行 参数等精确字符串,未来可能需要 BM25 或 Hybrid Search 补充。
6. 三个核心组件的职责边界
| 组件 | 输入 | 输出 | 负责 | 不负责 |
|---|---|---|---|---|
| Embedding 模型 | 文本 | 固定维度向量 | 建立可比较的语义表示 | 搜索、回答问题 |
| pgvector | 查询向量、已存向量 | 排序后的 Chunk ID/距离 | 向量存储与最近邻检索 | 理解原文、生成答案 |
| LLM | Question、Context | 自然语言答案 | 归纳与生成 | 在数据库中找资料 |
排查问题时也应沿边界定位:
资料没召回 → 检查 Document / Chunk / Embedding / Query / Top K
资料召回正确但答案错误 → 检查 Context / Prompt / LLM
7. 为什么原文和向量都要保存
document_chunks 同时保存:
content   → 给人和 LLM 阅读
embedding → 给数据库计算距离
metadata  → 保留标题、序号等结构化线索
向量只适合比较,不适合展示;原文适合阅读,却不能直接进行高效语义排序。二者承担不同职责。
8. RAG、直接长 Prompt 与 Fine-tuning 的区别
| 方案 | 知识放在哪里 | 更新知识 | 适合场景 |
|---|---|---|---|
| 直接把全文放进 Prompt | 本轮输入 | 每次重新发送 | 文档很少、一次性任务 |
| RAG | 外部知识库,按需检索 | 重建变化文档的索引 | 私有知识、频繁更新、需要来源 |
| Fine-tuning | 模型参数中的行为模式 | 重新训练 | 固定格式、风格、任务行为适配 |
Fine-tuning 通常不是给模型“安装一个可随时更新的事实数据库”。需要频繁更新、引用来源的知识问答, RAG 往往更合适;二者也可以组合。
9. 当前项目刻意保持最小化
第一版没有加入:
- HNSW / IVFFlat;
- BM25 / Hybrid Search;
- Reranker;
- Query Rewrite / Multi Query;
- LangChain / LlamaIndex;
- Agentic RAG / Graph RAG。
这不是说它们没有价值,而是先固定最短链路:
Chunk → Embedding → Vector Search → Top K → Context → LLM只有看得见最短链路,后续发现 Code/API 检索差、相似主题混淆或延迟过高时,才知道新组件解决的是 哪个具体问题,而不是盲目堆叠技术名词。
10. 初学者常见误区
- “向量数据库保存的只有向量。” 还必须保存或关联原文,否则检索后没有文字交给 LLM。
- “相似度 0.8 表示答案有 80% 正确。” 它只表示该模型空间中的相对接近程度。
- “Top K 越大越保险。” 更多噪声可能降低生成质量并增加 Token。
- “Embedding 模型越大,RAG 一定越好。” 效果取决于真实语料和问题,必须 Benchmark。
- “换模型只需改一个环境变量。” 文档向量和查询向量必须来自同一模型,通常要重建索引。
- “Retriever 找对了,LLM 就一定答对。” 生成阶段仍可能误读、遗漏或幻觉。
- “RAG 等于向量数据库。” 向量检索只是 RAG 中间的一步。
11. 代码地图
| 概念 | 代码位置 |
|---|---|
| 配置与参数 | src/config.py |
| Markdown 与 Document | src/markdown_loader.py |
| Chunk 与 Overlap | src/chunker.py |
| Embedding | src/embedding.py |
| PostgreSQL / pgvector | src/database.py、sql/init.sql |
| 索引链路 | src/ingest.py |
| Retriever / Top K | src/retrieval.py |
| Context / Prompt / LLM | src/llm.py |
| 命令入口 | src/cli.py |
下一篇将沿着这张地图逐段阅读真实代码,并通过命令观察每一步的输出。
12. 自测题
先不用看答案,尝试自己解释:
- 为什么不能把整个知识库每次都发给 LLM?
- Chunk 太大和太小分别会带来什么问题?
- 为什么数据库既保存
content又保存embedding? <=>得到的是距离还是相似度?排序时应该升序还是降序?- 为什么换 Embedding 模型后需要重新生成文档向量?
search已经找到正确片段,但ask回答仍错误,应优先检查哪一阶段?- RAG 与 Fine-tuning 各自更适合解决什么问题?
能用自己的话完整回答这些问题,说明你已经建立了最小 RAG 的整体概念。