检索和回答质量再高,也不能抵消一次权限泄漏、旧版本误召回或不可接受的长尾延迟。本篇把这些不能被平均分掩盖的问题纳入统一 Gate。
1. 权限泄漏为什么不能使用平均分
企业 RAG 的语料往往属于不同租户、团队或用户。检索 SQL 如果只按向量距离排序,没有在检索前应用授权过滤,就可能把“语义最相似但无权访问”的 Chunk 送进 Context。
权限测试必须包含请求主体和每个 Chunk 的访问属性,逐条判断:
请求主体 tenant/team/user
→ 检索前权限过滤
→ 返回 Chunk 的 owner/visibility/ACL
→ 任意私有越权即 Gate FAIL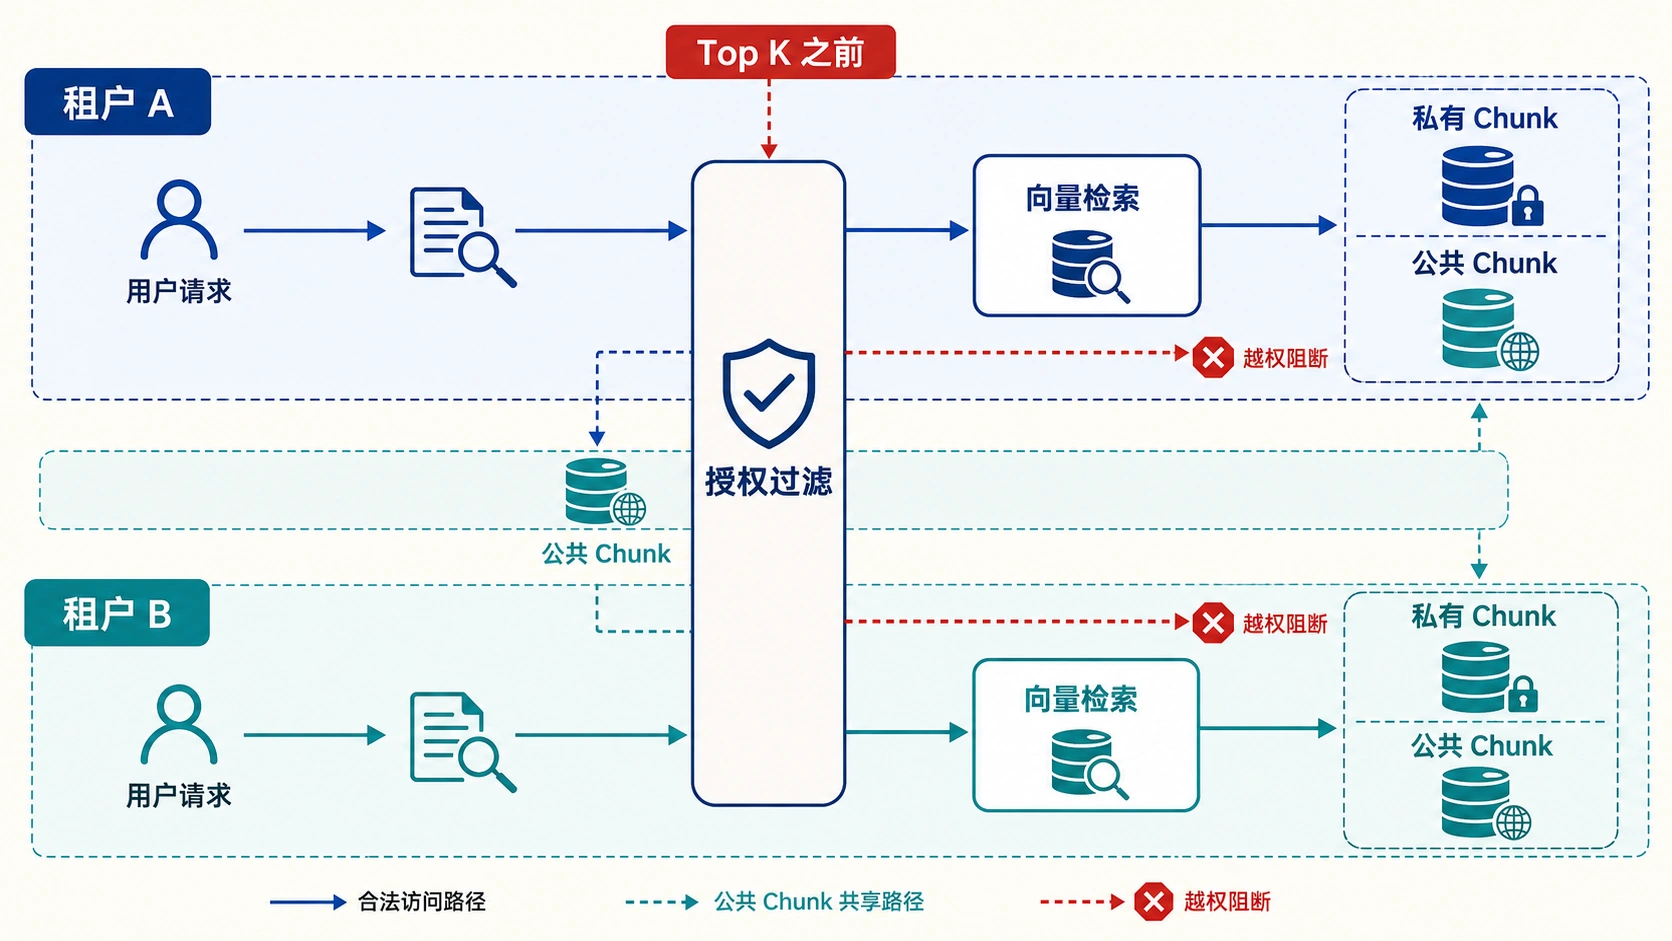
为什么不能报告“99.9% 权限准确率”?因为剩余 0.1% 可能就是敏感信息泄漏。安全 Gate 的条件应是越权返回数为 0;缺少主体字段或测试证据时也必须失败,不能把未知当作零。
第二阶段隔离 fixture 共返回 7 个 Chunk,其中 3 个越权,泄漏率为 0.4286;生产只读审计进一步发现当前 Schema 没有 tenant_id、owner_id、visibility、ACL 等可用于检索过滤的字段。因此生产权限隔离能力不能被证明,发布 Gate 失败。
2. 文档生命周期与索引新鲜度
知识库不是静态文件夹。文档会新增、更新、重命名和删除,索引需要保持同样的生命周期:
| 事件 | 正确行为 | 典型失败 |
|---|---|---|
| 新增 | 新 Chunk 可检索 | 文件存在但未索引 |
| 同路径更新 | 旧 Chunk 失效,新 Chunk 生效 | 新旧版本同时出现 |
| 重命名 | 新路径有效,旧路径清理 | 旧路径残留 |
| 删除 | 对应文档与 Chunk 不再返回 | 已删内容仍被召回 |
| 重复导入 | 只保留一个有效版本 | 重复 Chunk 挤占 Top K |
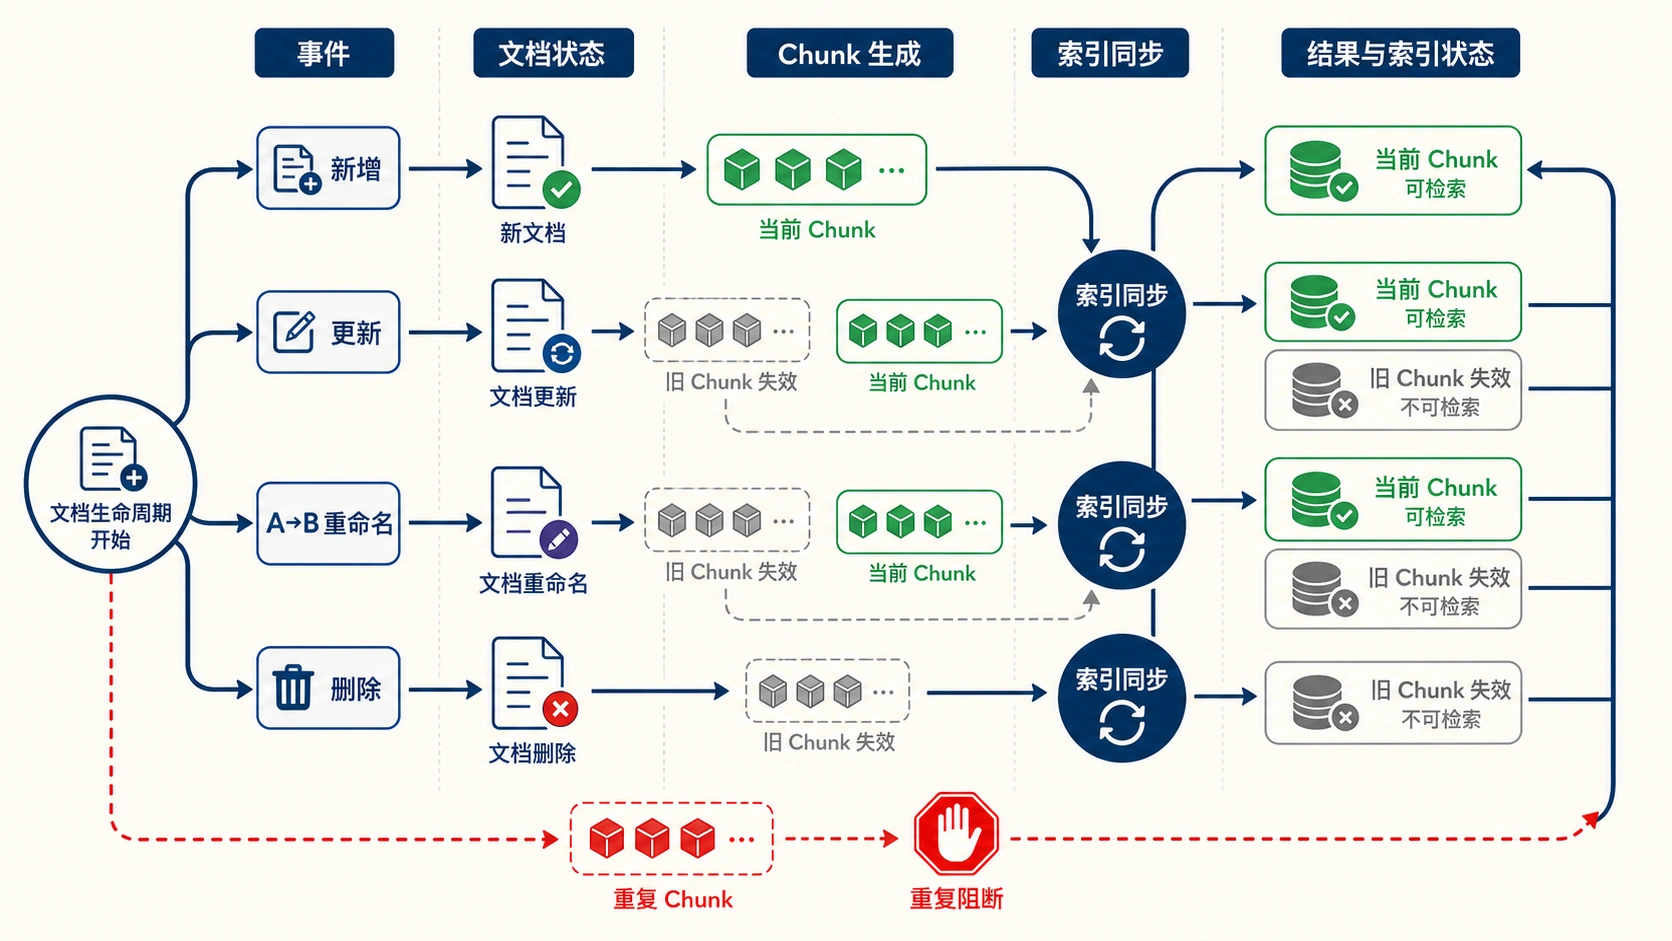
生命周期指标包括旧版本召回数、重复 Chunk 数、缺失有效 Chunk 和失败场景 ID。任一有效旧版本被召回都可能给出过期配置,因此属于硬门槛。
本轮 7 个隔离生命周期场景全部发现旧版本召回,其中 1 个还存在重复 Chunk。生产审计发现文件系统有 38 篇文档、索引只有 35 篇,且 Schema 没有版本或有效期字段。因此 document_lifecycle Gate 失败。
3. P50、P95 与长尾延迟
平均延迟会掩盖长尾。假设 95 次请求耗时 100 ms、5 次耗时 5 s,平均值看起来还可能“可接受”,但每二十个用户就有一个明显卡顿。
- P50:一半请求不超过该值,表示典型体验;
- P95:95% 请求不超过该值,观察长尾;
- Mean:适合容量估算,但不能单独代表体验。
本项目按阶段记录 Embedding、Search、Context 和 LLM,而不只记录总耗时。最终归档中检索总耗时 P50 为 149.6 ms、P95 为 175.4 ms,其中 Search P50 为 24.3 ms,主要时间来自 Embedding 请求。
需要特别注意:归档的回答路径使用确定性脚本,没有真实 LLM 生成,所以 llm_ms 接近 0,不能当作线上生成延迟。性能报告必须和运行模式一起解释。
4. Token、模型请求次数与实验成本
成本评测至少记录:
- 按类型划分的外部模型请求数;
- Embedding、Prompt、Completion Token;
- 单题和整体用量;
- P95 Token;
- 经过审核的单价存在时才计算货币费用。
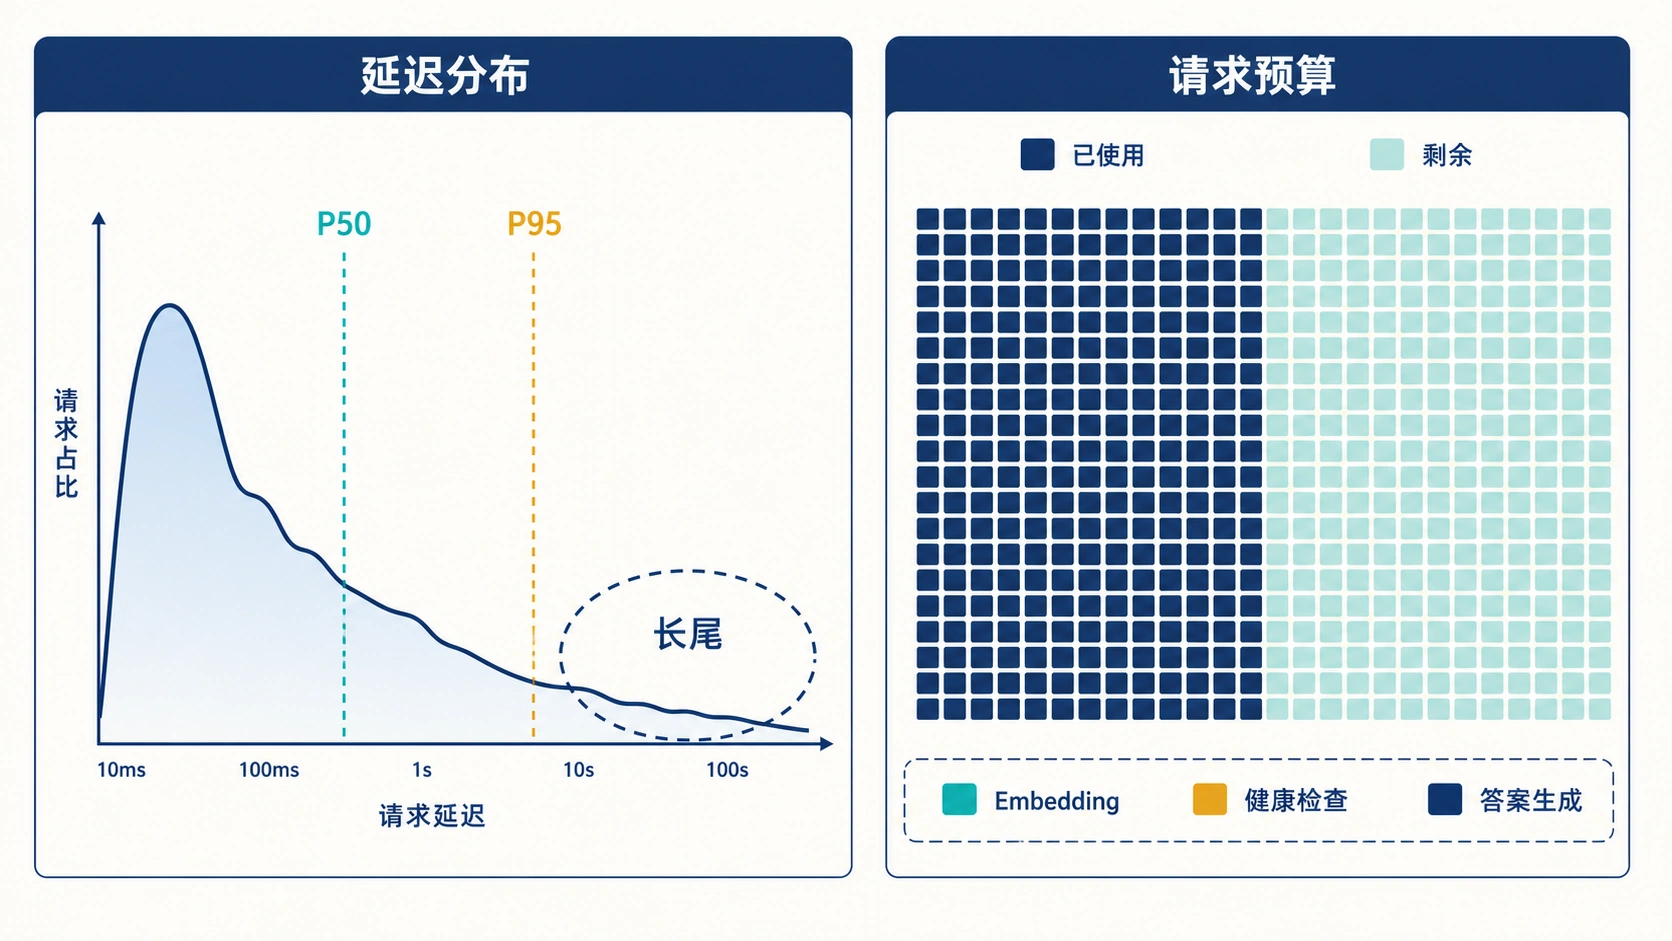
第二阶段设置 500 次硬请求预算,实际使用 274 次:272 次 Embedding、2 次健康检查;剩余 226 次。两个模型的查询 Embedding Token 合计 10551。由于没有配置经审核的价格,报告将货币成本保留为 null,而不是猜测一个数字。
请求预算还必须支持断点续跑:已完成题目不重复请求,准备发出新请求前先检查是否超过硬上限。这样实验中断不会带来重复费用,日志也能解释每次外部调用的用途。
5. Manifest、Snapshot 与完整可追溯性
一个总分如果不能回答“用什么代码、什么数据、什么模型跑出来”,就无法复现。Manifest 至少固定:
experiment_id
git_commit
snapshot_hash
models + dimensions
Top K + distance
questions + corpus
Prompt hash
request budget
created_at
Snapshot 关注语料和切块身份,Manifest 关注一次实验身份,逐题 JSONL 保存实际检索与评分证据。三者共同形成链路:
汇总指标 → 逐题记录 → Top K / Context / Fact / Citation
        → Question Schema → Snapshot → Git Commit
原子写入和命名产物清单同样重要。程序中途失败时,不能留下半个 JSON 冒充完成结果;统一报告必须列出缺失产物,并让完整性 Gate 失败。
6. 统一报告与双状态 Gate
统一报告固定为八段:环境与 Snapshot、数据覆盖、检索、无答案、Context/回答、系统约束、逐题变化、Gate 结论。每个汇总值都能回到对应 JSON 或 JSONL。
评测体系完整 Gate
检查所有命名产物、数据校验、审核记录、两个模型结果、阈值、回答、系统、基线和逐题证据是否存在。缺少任何必需证据都不能默认为通过。
RAG 发布 Gate
硬门槛包括数据协议、权限隔离和文档生命周期;质量门槛用原 Stage 1 同一批题比较 Hit@1、MRR 和 Recall@5,总体退化容忍度 0.01,重要分类容忍度 0.05。
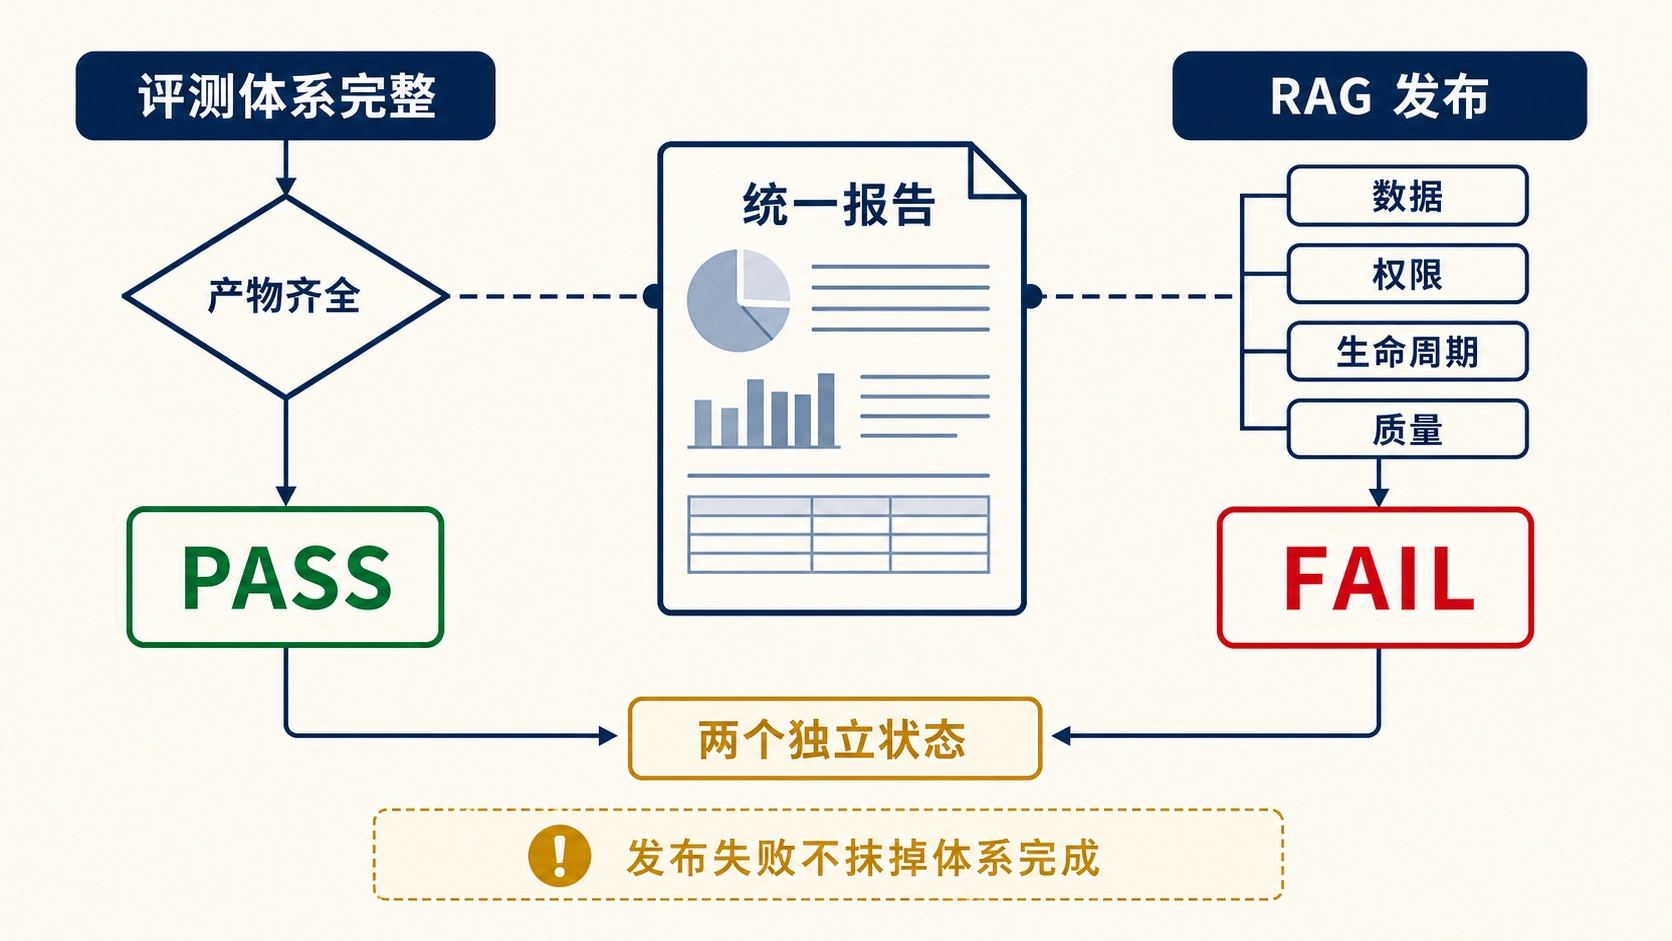
本轮结果为:
| Gate | 结果 | 依据 |
|---|---|---|
| 评测体系完整 | PASS | 所有必需产物齐全,无 completion failure |
| 数据协议 | PASS | 136 题校验通过 |
| 检索回归 | PASS | 没有超过容忍度的退化 |
| 权限隔离 | FAIL | 生产 Schema 缺少授权字段 |
| 文档生命周期 | FAIL | 缺少版本能力且存在未索引文档 |
| RAG 发布 | FAIL | 两项硬门槛失败 |
双状态设计让结论既不粉饰当前 RAG,也不否定评测工作的完成。下一步不是继续扩大报告,而是把权限和生命周期失败分别转成第三阶段 Issue,用同一套测试证明修复是否生效。