检索命中只是“模型有机会答对”。本篇继续验证最终回答是否覆盖标准事实、是否只使用 Context、是否回应问题,以及引用是否真正支持结论。
1. 回答评测应该从哪里开始
回答评分之前,先检查两项前置证据:
- 必要 Gold 是否进入 Retriever Top K;
- 必要事实是否进入最终 Context。
如果第一项失败,答案错主要是检索上限;如果第一项成功而第二项失败,问题在 Context Builder;只有两项都成功后,回答仍错,才有充分理由调查 Prompt 或 LLM。
回答评测还要区分两种输入:
- 真实在线回答:能评价实际模型表现,但有随机性、成本和 Prompt 版本问题;
- 确定性 Context 能力上限:只把 Context 中可见的标准事实组织成结构化答案,用于验证“当前证据最多能答到什么程度”。
第二阶段最终报告采用后者,没有使用 LLM-as-Judge,也没有发起在线答案生成请求。因此高分代表 Context 可见事实上限,不代表真实 LLM 自由文本质量。
2. Correctness:标准事实覆盖了多少
一个完整答案可能包含多个 Fact。问题记录为每个 Fact 分配稳定 ID,并列出允许的支持 Chunk:
{
  "id": "Q120-F1",
  "text": "配置 A 在新版本中改为 B",
  "supporting_chunk_ids": [1201, 1202]
}
回答输出 fact_ids,Correctness 再比较回答事实与标准事实。这样能区分完全正确、部分正确和完全遗漏,也允许不同 Chunk 支持同一事实。
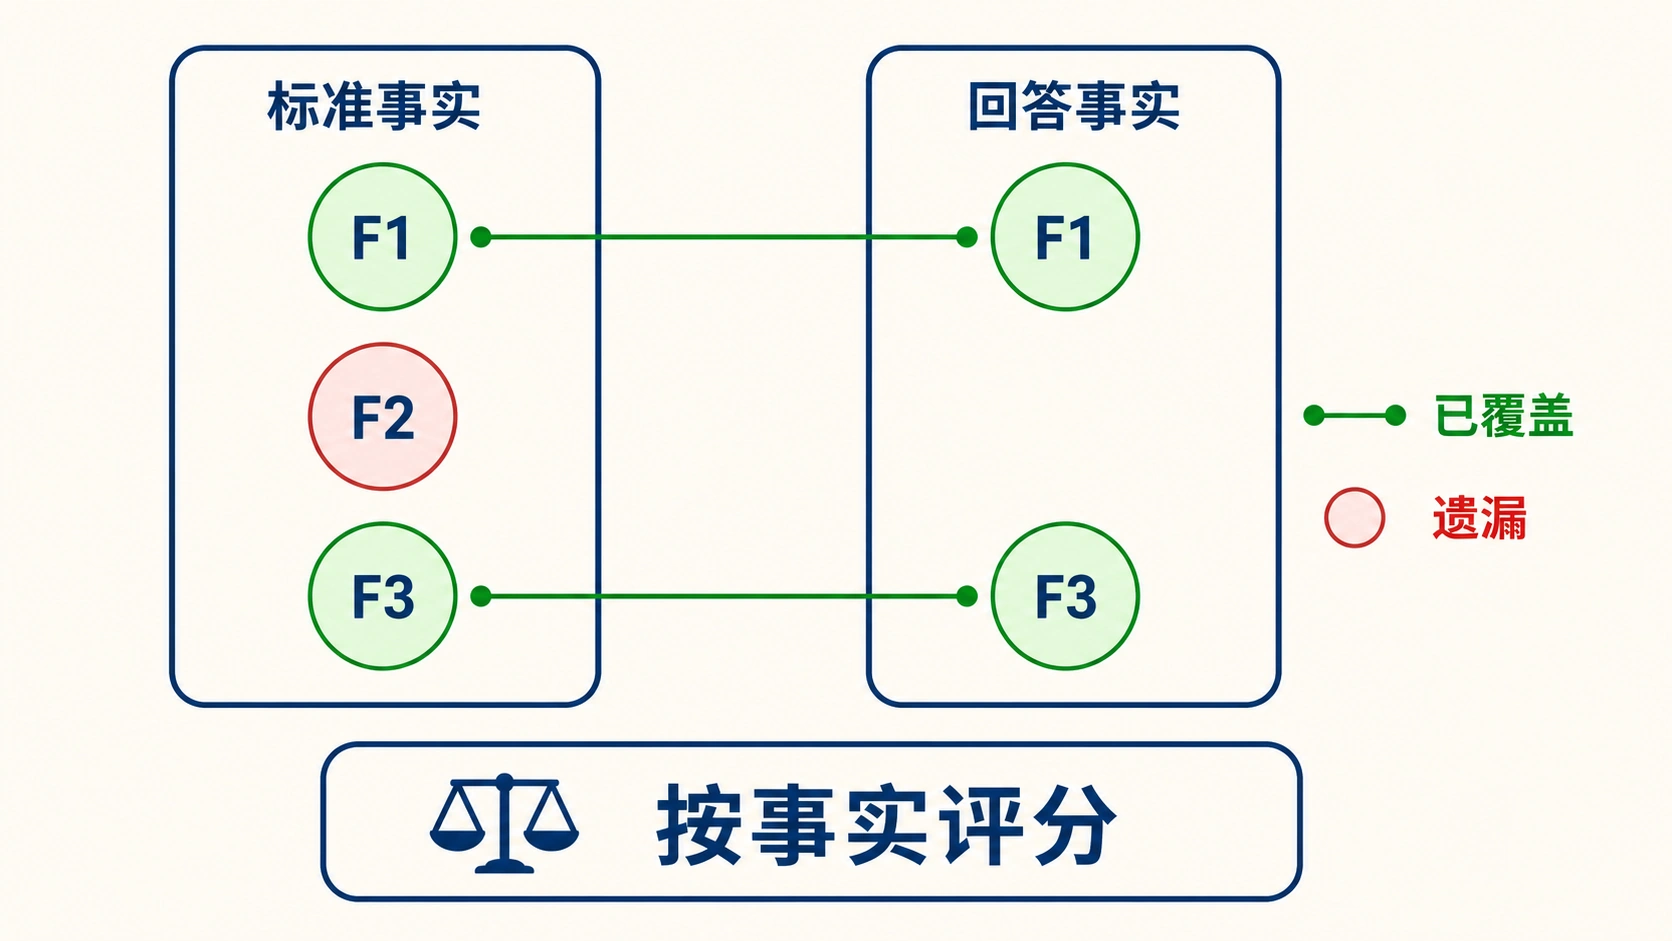
只比较自由文本相似度不够可靠:“不要启用 A”和“启用 A”可能只有一个词不同,却语义相反;一段冗长答案也可能因关键词多而获得较高相似度。事实 ID 把评分单位从文风改为可审核主张。
最终确定性实验的 Correctness 为 0.9886,但必须连同其方法名一起报告:deterministic_context_ceiling_with_fact_ids_and_context_citations。
3. Faithfulness:回答是否有 Context 依据
Correctness 问“是否符合标准答案”,Faithfulness 问“当前回答是否能由给定 Context 支持”。二者不是同一件事。
假设正确答案是 Kafka 参数 X=30:
- Context 中有
X=30,回答也写X=30:正确且忠实; - Context 中没有该事实,模型凭预训练知识写
X=30:可能正确,但不忠实; - Context 中写
X=20,回答写X=30:既不正确也不忠实; - 回答只覆盖部分可见事实:可能忠实但不完整。
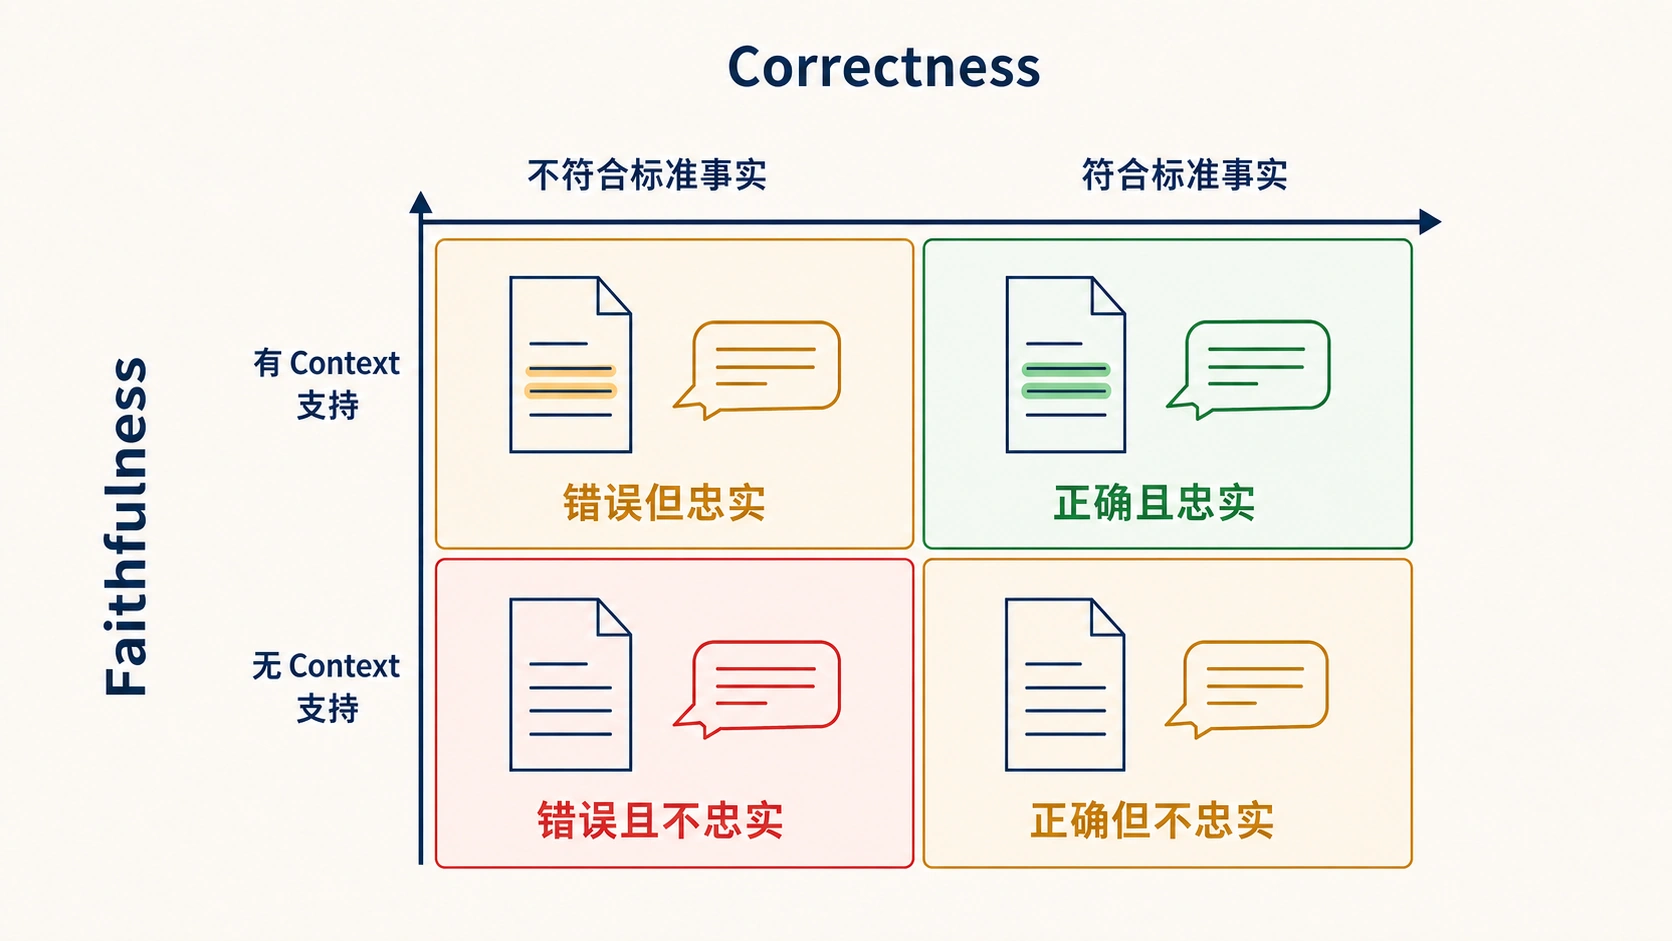
结构化评测会检查回答中的 Fact 是否存在于 Context 可见事实集合。自由文本线上评测则需要人工或 Judge 逐主张核对,成本更高,也必须防止 Judge 使用 Context 之外的知识替模型圆场。
4. Answer Relevance:是否真正回应用户问题
一个回答可以事实正确、句句有依据,却没有真正解决用户问题。例如用户询问“如何设置 TTL 以及何时续期”,回答只解释 TTL 的定义;内容正确而且来自文档,但遗漏了配置和更新策略。
Answer Relevance 关注:
- 是否覆盖问题要求的各个子任务;
- 是否遵守版本、语言、格式等显式约束;
- 是否把大量无关背景当作答案主体;
- 无答案时是否清楚说明信息缺口,而不是转移话题。
在本项目的确定性上限中,Relevance 通过标准 Fact 覆盖和拒答状态近似计算,因此与 Correctness 同为 0.9886。这是可重复基线,不等同于对真实自然语言简洁度和可读性的完整判断。
5. Citation Precision 与 Citation Recall
引用评测连接三个对象:
回答主张 Fact
→ 引用 Chunk
→ Chunk 是否支持该 Fact
Citation Precision
回答给出的引用中,有多少真的支持对应主张。低 Precision 表示引用存在“装饰性”:看起来有出处,但点开后找不到证据。
Citation Recall
需要证据的关键 Fact 中,有多少拥有有效引用。低 Recall 表示部分重要结论没有来源。
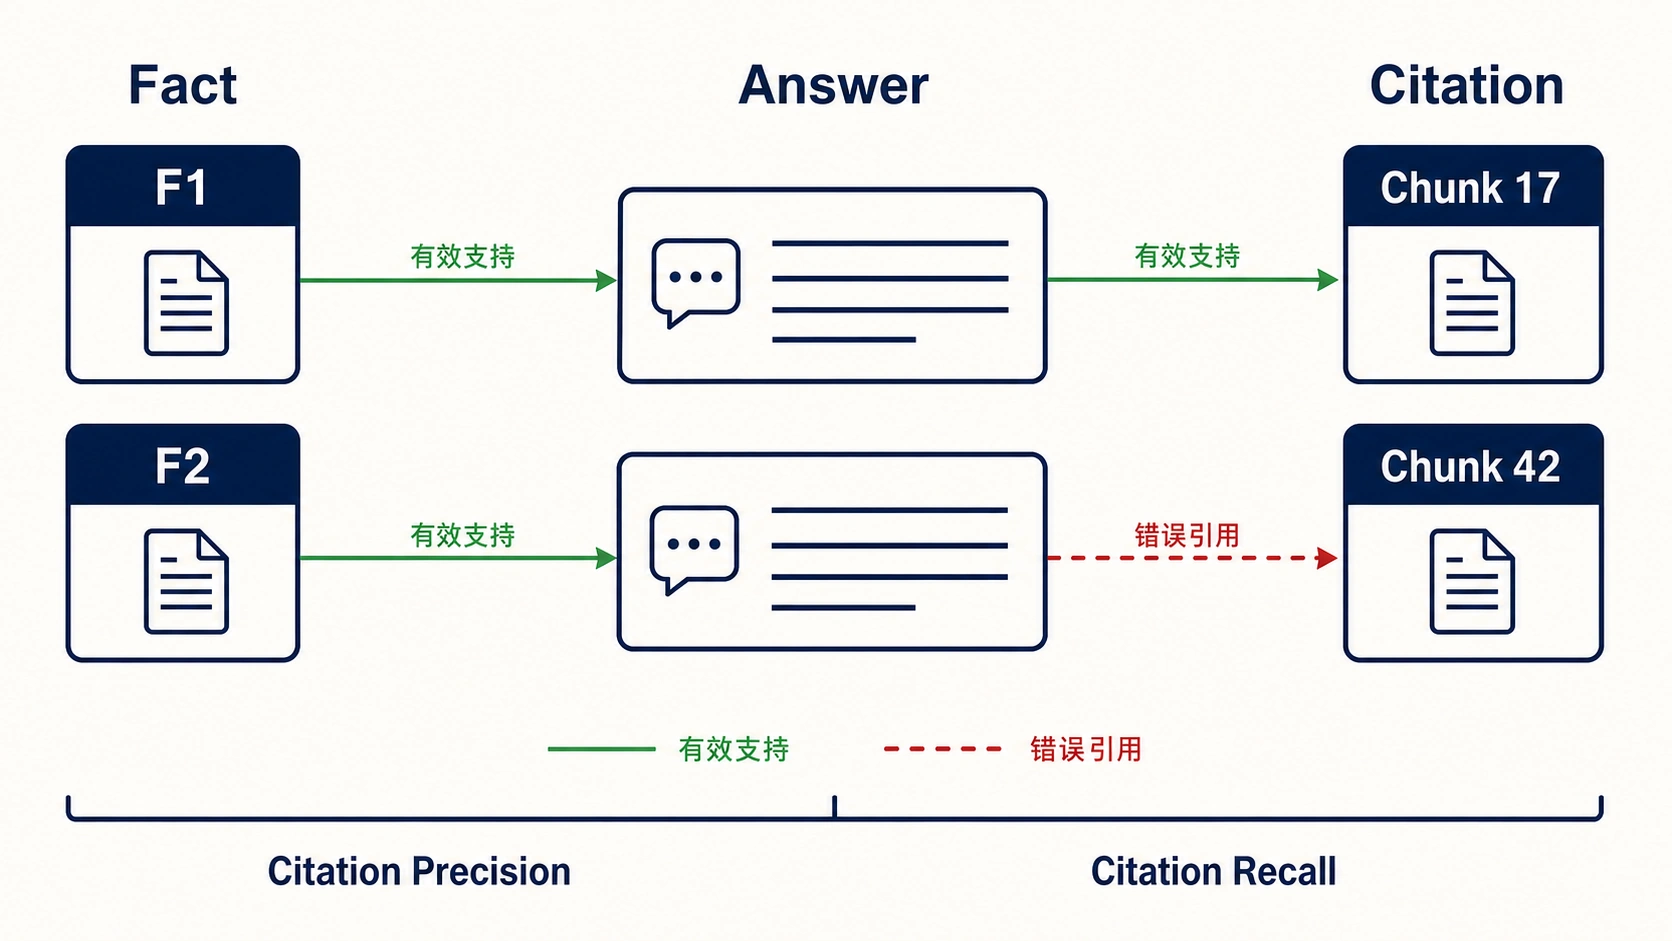
最终实验两项引用指标都是 1,因为确定性脚本只为 Context 中可见的 Fact 选择允许的支持 Chunk。这个结果证明引用协议和评测代码可用,不能证明真实 LLM 总能生成完美引用。真实在线答案仍需单独采集并评分。
6. 确定性评测、人工评测和 LLM-as-Judge
三种方法各自适合不同问题:
| 方法 | 优点 | 局限 | 适合验证 |
|---|---|---|---|
| 确定性脚本 | 快、便宜、可重复 | 依赖结构化 Fact,难评文风 | 协议、Context 上限、回归 |
| 人工评测 | 能理解复杂语义和可用性 | 慢、贵、需要一致性校准 | 真实回答质量、业务风险 |
| LLM-as-Judge | 可扩展、能处理自由文本 | 有偏差、提示敏感、可能自评 | 经人工校准后的辅助评分 |
第二阶段明确记录:
- Judge 未使用;
- 回答生成请求为 0;
- 132 道正式题完成确定性能力上限评分;
- AI 双重审核不能冒充人工标注;
- 人类标注者一致性校准仍未完成。
这组限制必须和分数一起展示。一个可信报告不仅告诉读者测到了什么,还主动标出没有测到什么。
下一步若要加入真实 LLM 评分,应先冻结 Prompt 哈希和模型版本,采集逐题原始回答,建立人工校准子集,再验证 Judge 与人工结论的一致性。不能直接把 Judge 的单个总分加入发布 Gate。