本篇先不讲指标公式,也不急着打开代码。我们先回答一个更根本的问题:一个 RAG 系统已经能返回答案,为什么还要花力气建立评测体系?
上一篇已经用固定语料和问题集比较了两个 Embedding 模型。本篇开始把“检索评测”扩展为覆盖数据、检索、Context、回答、引用、权限、版本、性能与成本的完整体系。
1. 为什么“人工问几个问题”不算评测
最自然的验收方法,是打开 CLI 连续问几个问题:答案读起来正确,就认为系统可用。这种方法适合冒烟检查,却不能支持工程决策。
首先,人工通常会挑自己熟悉、表达直接的问题。真实用户却会省略背景、混用中英文、粘贴错误码,或者询问两段文档才能共同回答的内容。三道简单题全部答对,不能证明困难场景也可靠。
其次,流畅会掩盖证据错误。LLM 可能依靠预训练知识补出一个看似正确的回答,但它引用的知识库 Chunk 并不支持这句话。只看文风,就会把“碰巧答对”当成“系统有依据地答对”。
最后,人工试问无法稳定重放。今天更换 Embedding,明天修改 Chunk Size,后天加入 Reranker;如果没有冻结问题、语料和指标,就无法判断变化来自哪一个组件。
评测体系的目标不是制造一个漂亮总分,而是建立可重复的因果证据:
同一输入 + 明确变量 + 固定指标 + 逐题证据
→ 知道哪里变好
→ 知道哪里退步
→ 知道下一步应该改什么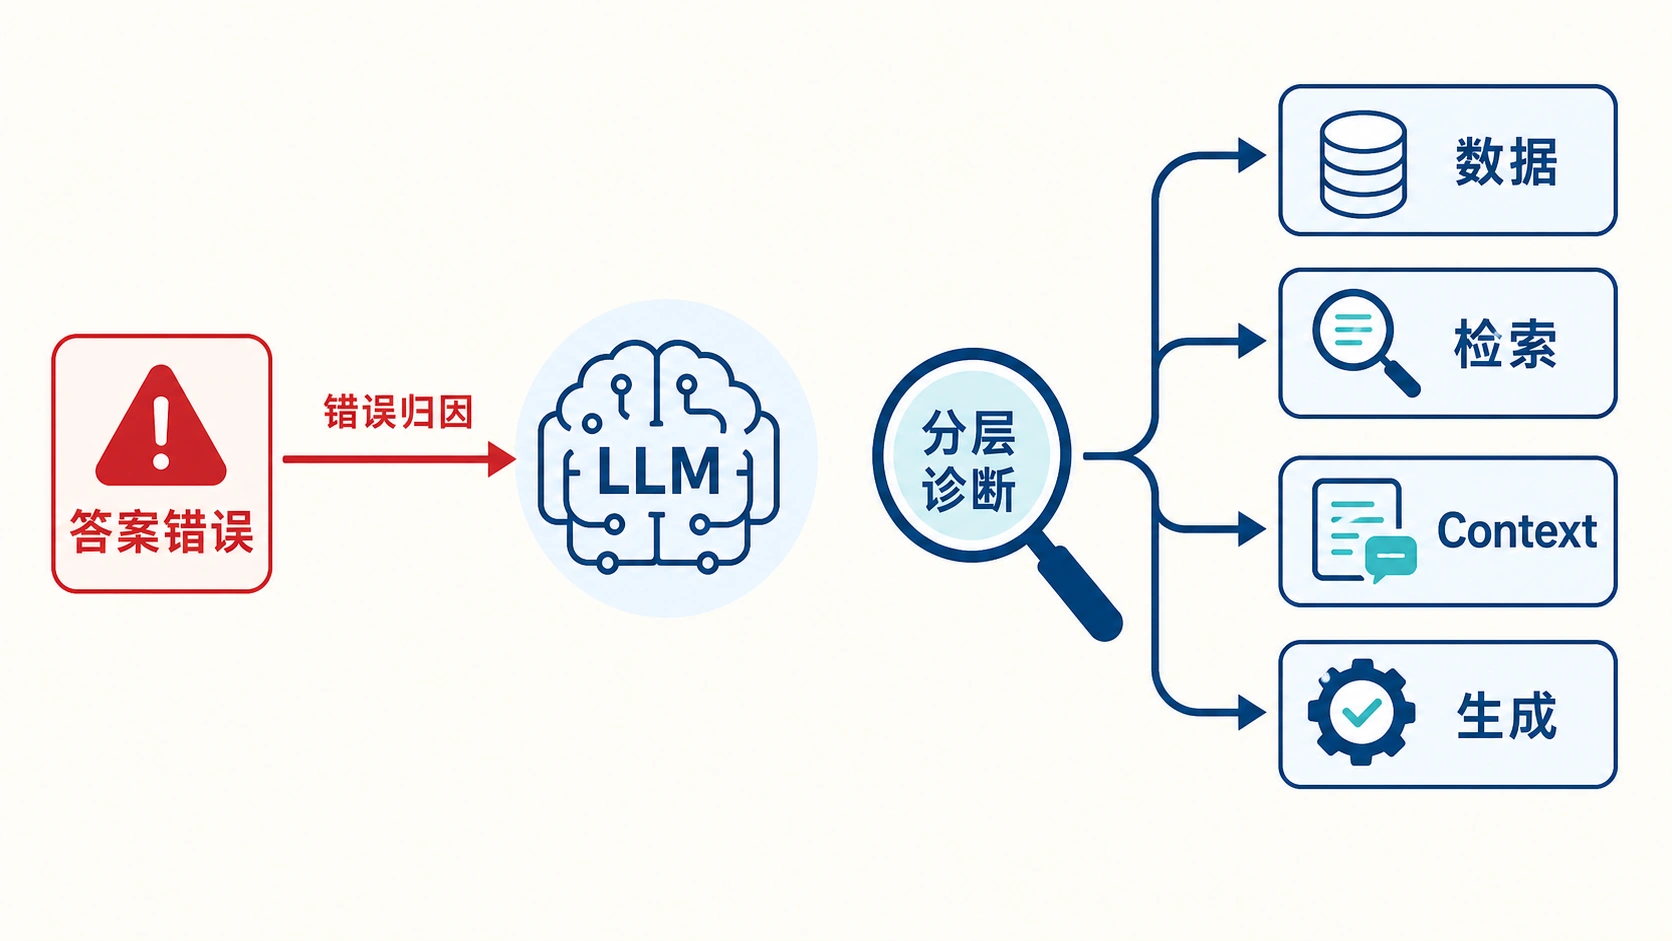
2. 答案错误可能发生在哪一层
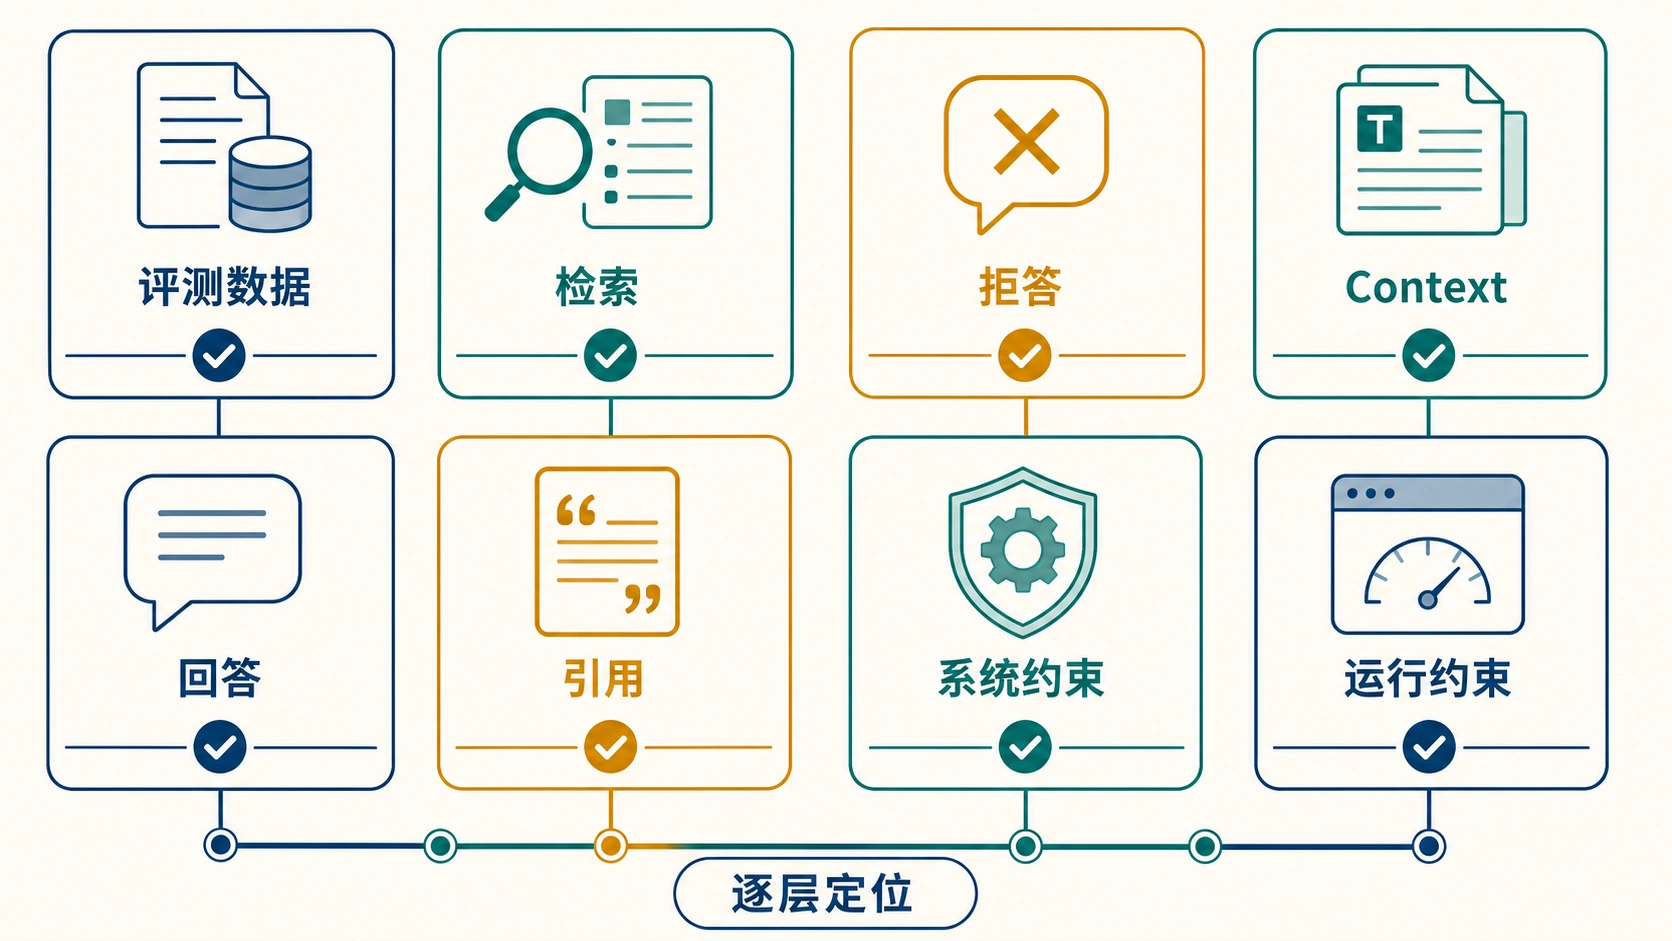
一次 RAG 请求至少经过八个可独立失败的层次:
| 层次 | 典型问题 | 不能直接归咎于 |
|---|---|---|
| 评测数据 | Gold 错、问题本身不可回答 | Retriever 或 LLM |
| 检索 | 正确 Chunk 没进 Top K | LLM |
| 拒答 | 无答案问题仍返回相似文档 | Prompt 文风 |
| Context | Gold 已检索到,但被预算或去重丢掉 | Embedding |
| 回答 | Context 正确,事实仍漏答或答错 | Retriever |
| 引用 | 答案正确,但引用不支持结论 | 正确性指标 |
| 系统约束 | 越权 Chunk、旧版本、重复索引 | 平均质量分 |
| 运行约束 | P95 延迟或请求成本不可接受 | 离线准确率 |
这张故障地图很重要,因为“最终答案错”只是一种外部症状。症状相同,修复动作可能完全相反:
- Gold 标错,应修数据;
- Gold 未召回,应查检索;
- Gold 被 Context 丢弃,应查预算和拼装;
- Context 完整但答案错,应查 Prompt 或生成模型;
- 答案泄露私有内容,应先阻断发布,而不是继续调准确率。
3. 为什么不能只看最终回答
假设问题需要事实 F1 和 F2,它们分别位于 Chunk 17 和 Chunk 42。
情况 A:Retriever 只找到 Chunk 17
LLM 缺少 F2,最终回答不完整。根因是 Recall 不足,应该研究 Embedding、Hybrid Search、Reranker 或 Chunk 边界。
情况 B:两个 Chunk 都在 Top 10,但 Context 预算只保留 Chunk 17
检索已经成功,问题发生在 Context Builder。继续更换 Embedding 不会解决它。
情况 C:两个事实都进入 Context,LLM 仍加入未被支持的 F3
这是 Faithfulness 问题,应检查生成约束、Prompt 或模型,而不是提高 Top K。
情况 D:答案和引用都正确,但用户无权读取 Chunk 42
这是安全失败。即使 Correctness、MRR 和 Citation Precision 都是 1,系统也不能发布。
因此,完整评测必须保留中间产物:Top K、最终 Context、结构化事实、引用、权限主体和文档版本。只有这样才能把错误定位到真正发生的层。
4. 从真实问题到指标和行动
本系列不会把指标当作需要背诵的术语。每个指标都用同一种方法理解:
真实问题
→ 构造能复现问题的场景
→ 选择只测这一层的指标
→ 观察逐题证据
→ 根据异常类型采取行动
例如,“多证据问题总是漏掉一半配置”是一个真实问题。对应场景必须标注多个 Gold 或多个 Fact 的替代证据;对应指标是 Recall@K 和 Fact Recall,而不是只看 Hit@K。Hit@K 只要命中一个 Gold 就会通过,无法验证证据是否找全。
再如,“知识库没有答案时仍编造配置”对应的是无答案场景。需要 Answerable 标签、硬负例、开发集和 Holdout;指标是混淆矩阵、拒答 Precision/Recall/F1,以及按模型绑定的阈值。它不是普通的检索命中问题。
一个指标只有同时回答下面五个问题才有工程意义:
- 它验证什么场景?
- 它的分子和分母是什么?
- 高分仍然可能掩盖什么?
- 低分通常指向哪一层?
- 下一项最便宜的验证是什么?
5. 评测体系完整与 RAG 可发布是两个状态
第二阶段采用两个相互独立的状态:
evaluation_system_complete:所有必需输入、指标、逐题结果、系统证据和统一报告是否齐全;rag_release_gate_passed:当前被测 RAG 是否满足数据、权限、生命周期和质量门槛。
这两个状态不能合并。评测体系发现当前系统存在严重问题,恰恰说明评测体系发挥了作用,不能因为 RAG 未通过就说评测体系未完成。同样,缺少权限测试时也不能因为检索分数很高就默认可发布。
本项目最终实验的真实结论是:
evaluation_system_complete = true
rag_release_gate_passed    = false
release_failures           = [permission_isolation, document_lifecycle]
这不是矛盾,而是一把完整的尺子测出了当前系统不满足发布条件。
6. 完整评测体系全景与阅读路线
第二阶段的数据流如下:
冻结语料与 Snapshot
→ 问题 Schema、Gold 与审核
→ 检索指标和逐题归因
→ 无答案阈值校准
→ Context 预算与证据保留
→ 回答事实、忠实度与引用
→ 权限、生命周期、延迟与成本
→ 统一报告
→ 完整性 Gate + 发布 Gate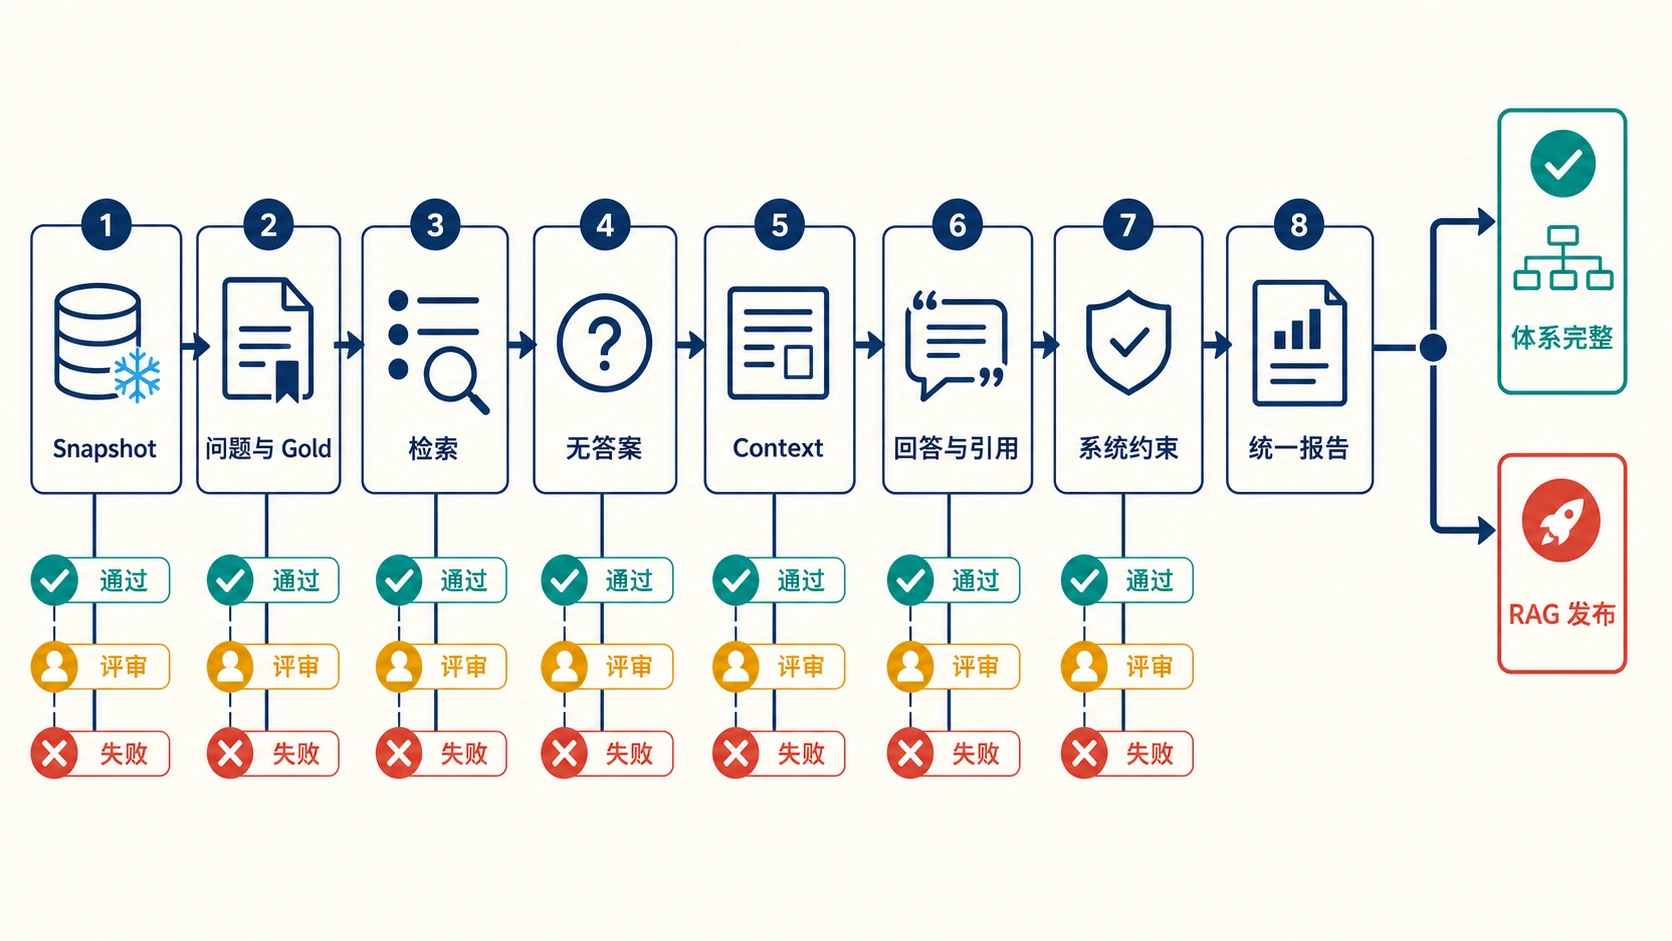
后续五篇分别回答:
- 如何建立可信试卷,并读懂检索指标;
- 如何判断无答案,以及检索结果进入 Context 后发生了什么;
- 如何评价回答、幻觉与引用;
- 如何评价权限、文档生命周期、性能与发布门槛;
- 如何从真实代码运行完整实验,并把失败转成第三阶段 Issue。
学完这一组文章,目标不是记住所有公式,而是看到一种失败现象时,能选择正确证据把问题定位到具体层。