本篇解决两个问题:怎样保证评测试卷可信,以及 Hit、Recall、Precision、MRR、nDCG、Pairwise 和置信区间分别验证什么场景。
1. 评测之前,为什么必须先保证试卷可信
检索指标比较的是“模型返回结果”和“事先标注的正确证据”。如果正确证据本身标错,再精确的公式也只会稳定地产生错误结论。
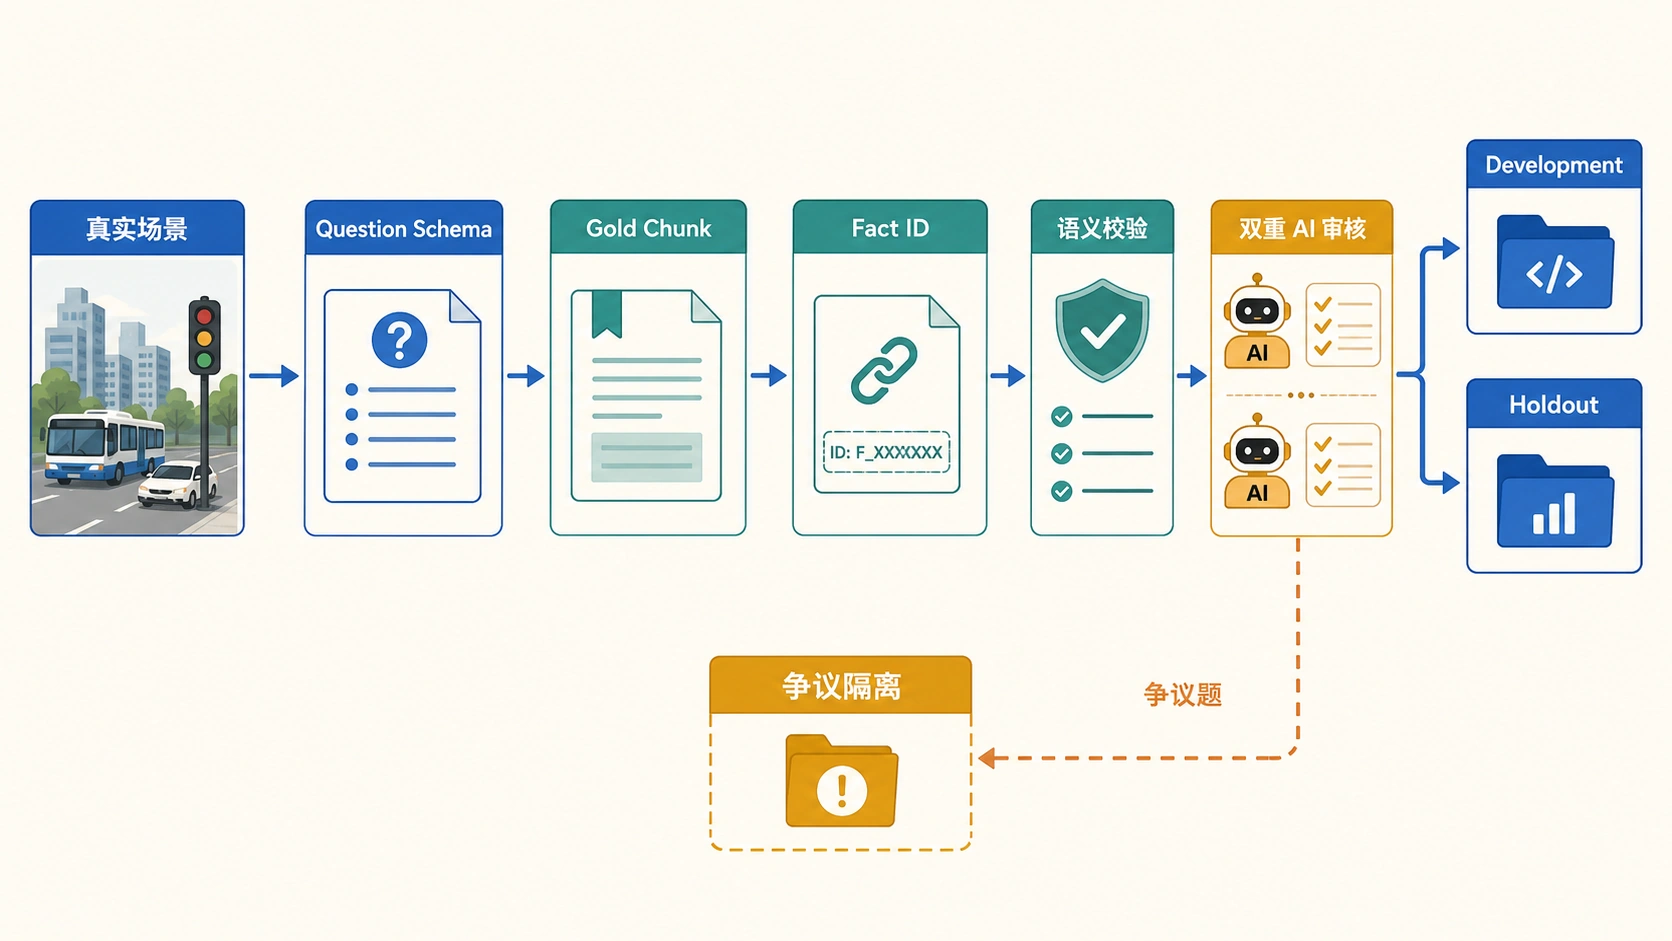
本项目把一条问题记录看成一份可审核的测试契约,核心字段包括:
| 字段 | 回答的问题 |
|---|---|
id | 这道题能否被稳定引用和回归? |
question | 用户实际会怎样提问? |
answerable | 冻结语料能否回答? |
gold_chunk_ids | 哪些 Chunk 是标准证据? |
key_facts | 完整答案必须覆盖哪些事实? |
graded_relevance | 各候选证据的相关程度是多少? |
distractors | 哪些相似文档容易造成误召回? |
category/tags/difficulty | 失败集中在哪类场景? |
split | 用于开发调参还是最终 Holdout? |
review | 谁用什么方法审核过? |
Gold 必须来自冻结语料,而不是从某个模型的 Top 1 反推。否则会形成“模型输出就是标准答案、标准答案又证明模型正确”的自证循环。
2. 问题 Schema、冻结快照和双重审核
Schema 负责检查字段形状,语义校验负责检查字段之间的关系。例如:
answerable=true时必须有 Gold;- 无答案题不能偷偷带入 Gold;
- Fact ID 必须唯一;
- Fact 的支持 Chunk 必须存在于冻结语料;
- 分级相关性只能使用有效 Chunk,等级必须在 0~3;
- 正式评测不能包含
disputed; - 原 Stage 1 题目的 ID、题面和 Gold 不能被升级脚本静默改写。
Snapshot 则固定语料与运行条件:文档数、Chunk 数、切块算法、维度、距离、模型和内容哈希。语料或切块变化后,旧 Gold 可能不再指向同一内容,因此必须生成新 Snapshot 并重新审核映射。
本轮最终数据集共有 136 题,其中 116 题可回答、20 题无答案;覆盖直接问题、改写、中英混合、Code/API、硬负例、多证据、代码/表格格式、权限和版本场景。两轮审核均由独立 AI reviewer 完成,不能表述为人工复核;4 道冻结争议题被保留但排除在正式质量指标之外。因此检索总体正式样本是 112 题,而不是 116 题。
3. Hit@K 与 Recall@K 分别验证什么
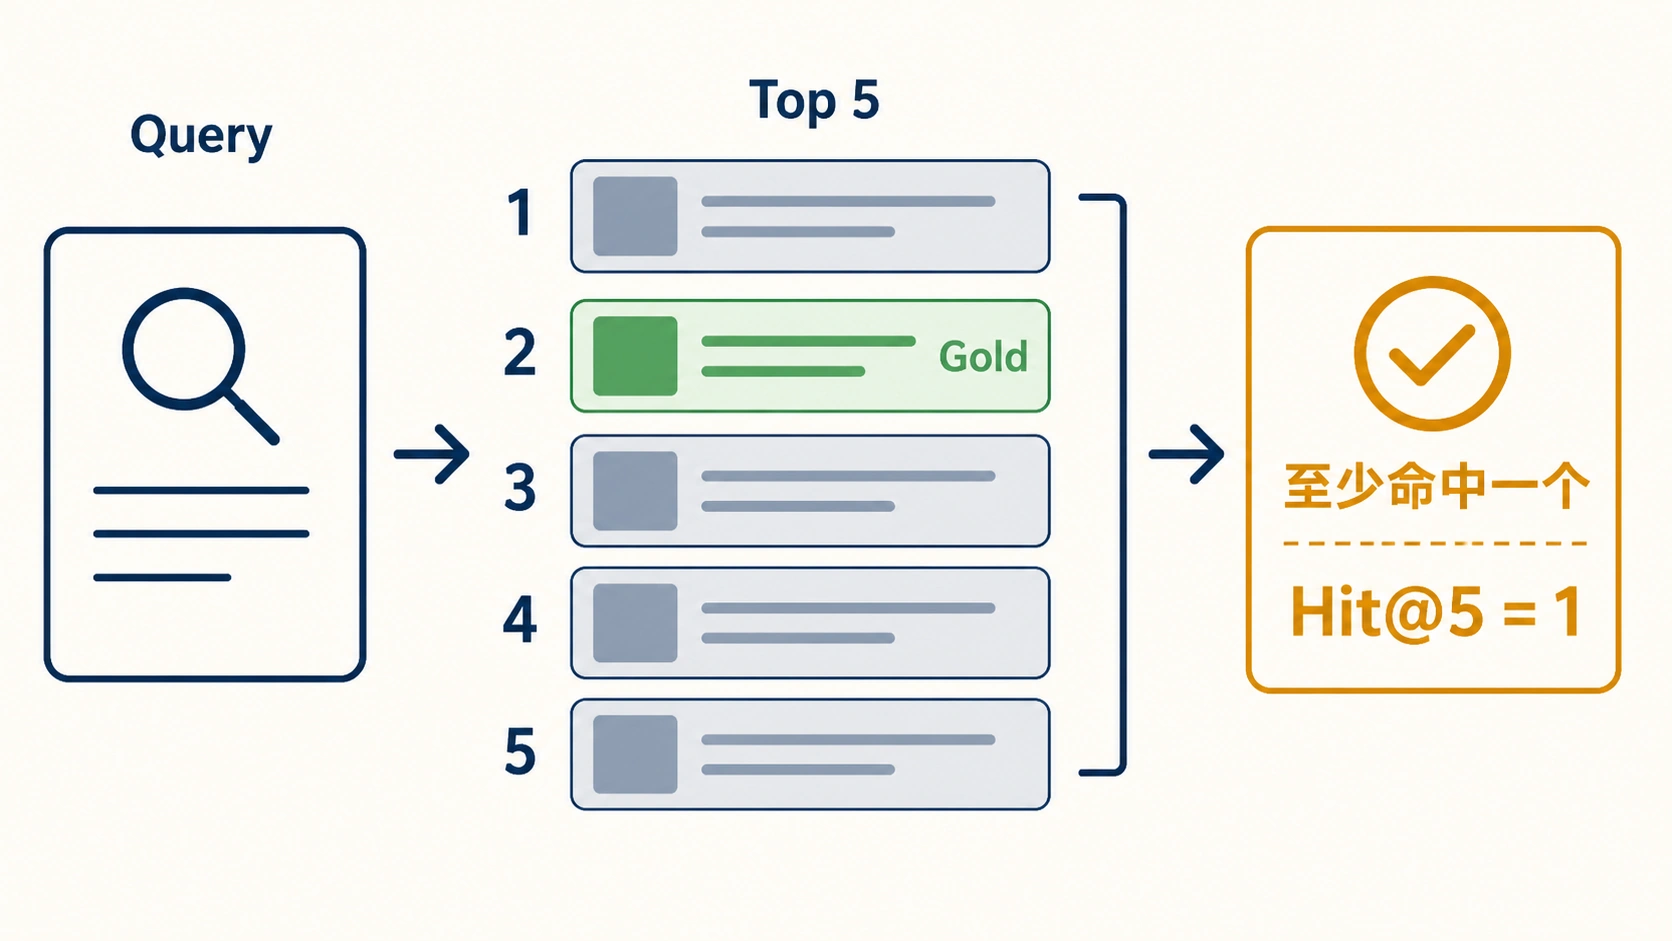
Hit@K:有没有找到至少一个正确入口
若 Top K 中至少出现一个 Gold,Hit@K 为 1,否则为 0:
Gold = {17, 42}
Top 5 = [8, 17, 5, 9, 10]
Hit@5 = 1
适用场景:答案集中在一个 Chunk,或只需要确认检索器能否找到一个有效入口。
盲点:上例需要两个 Gold,但只找到 17,Hit@5 仍是 1。它不能证明证据找全。
Recall@K:全部必要证据找回了多少
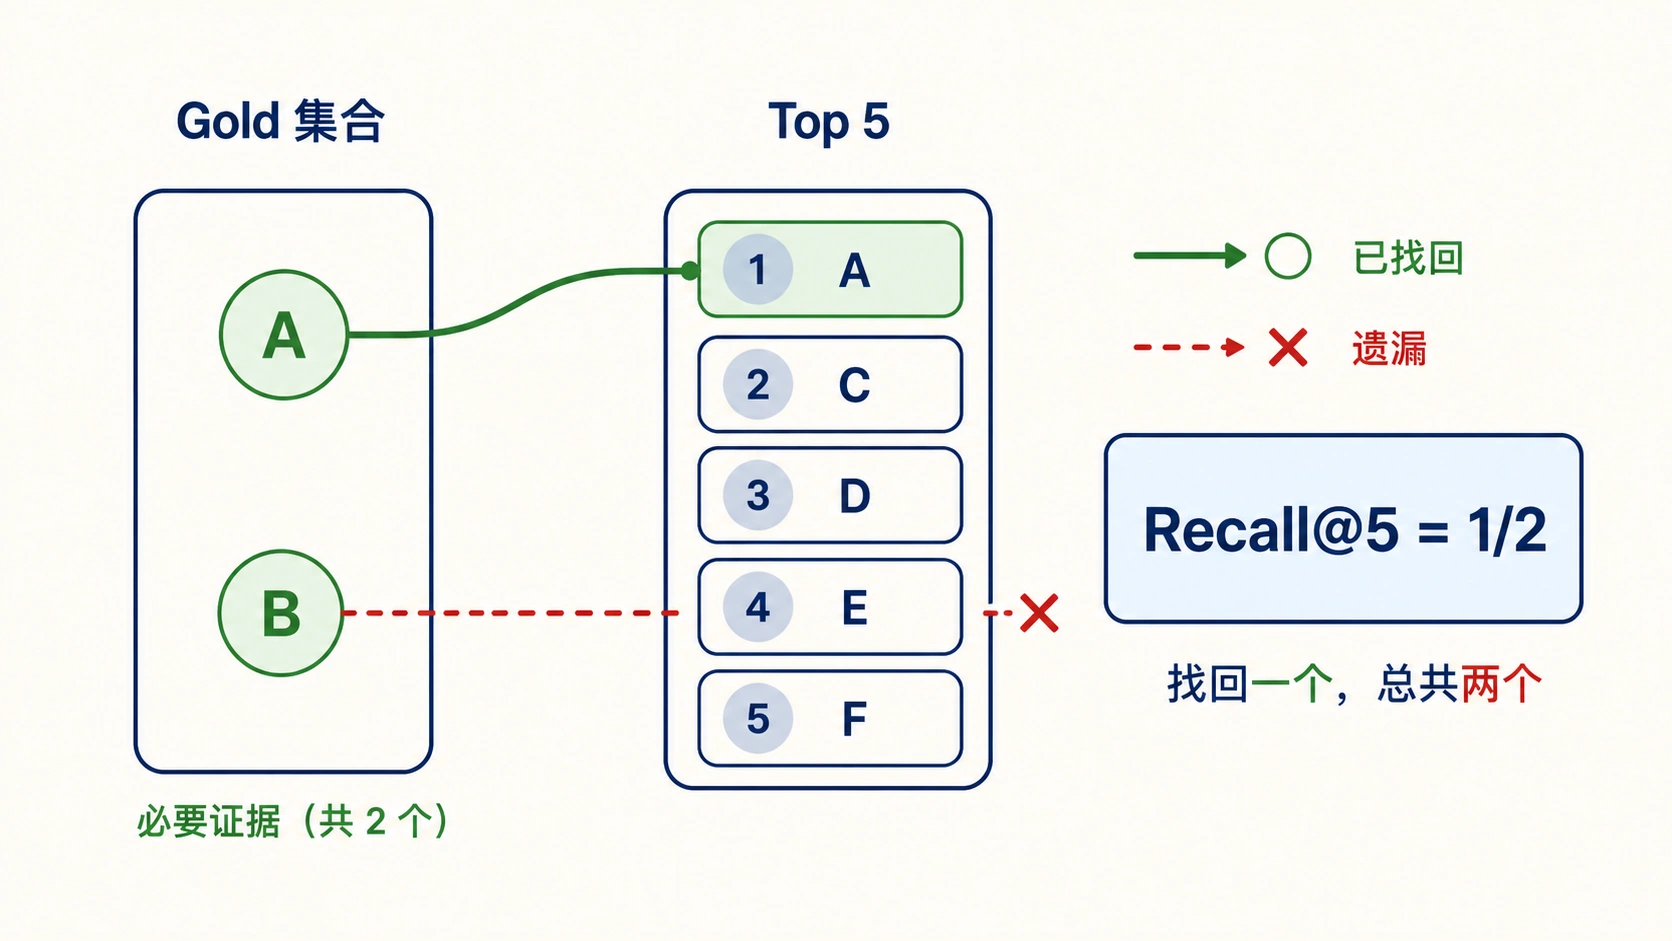
Recall@K = Top K 命中的 Gold 数 / 全部 Gold 数仍用上例:命中 1 个、总共 2 个,所以 Recall@5 = 0.5。多证据问题、跨章节比较、需要多个配置项共同回答的场景必须看 Recall。
本项目还计算事实级 Recall:不同 Chunk 可能都能支持同一 Fact,只要找到任一允许证据就算该事实可见。这比要求命中唯一 Chunk ID 更符合“证据可以等价表达”的现实。
4. Precision@K 与 MRR 分别验证什么
Precision@K:取回内容中有多少真正有用
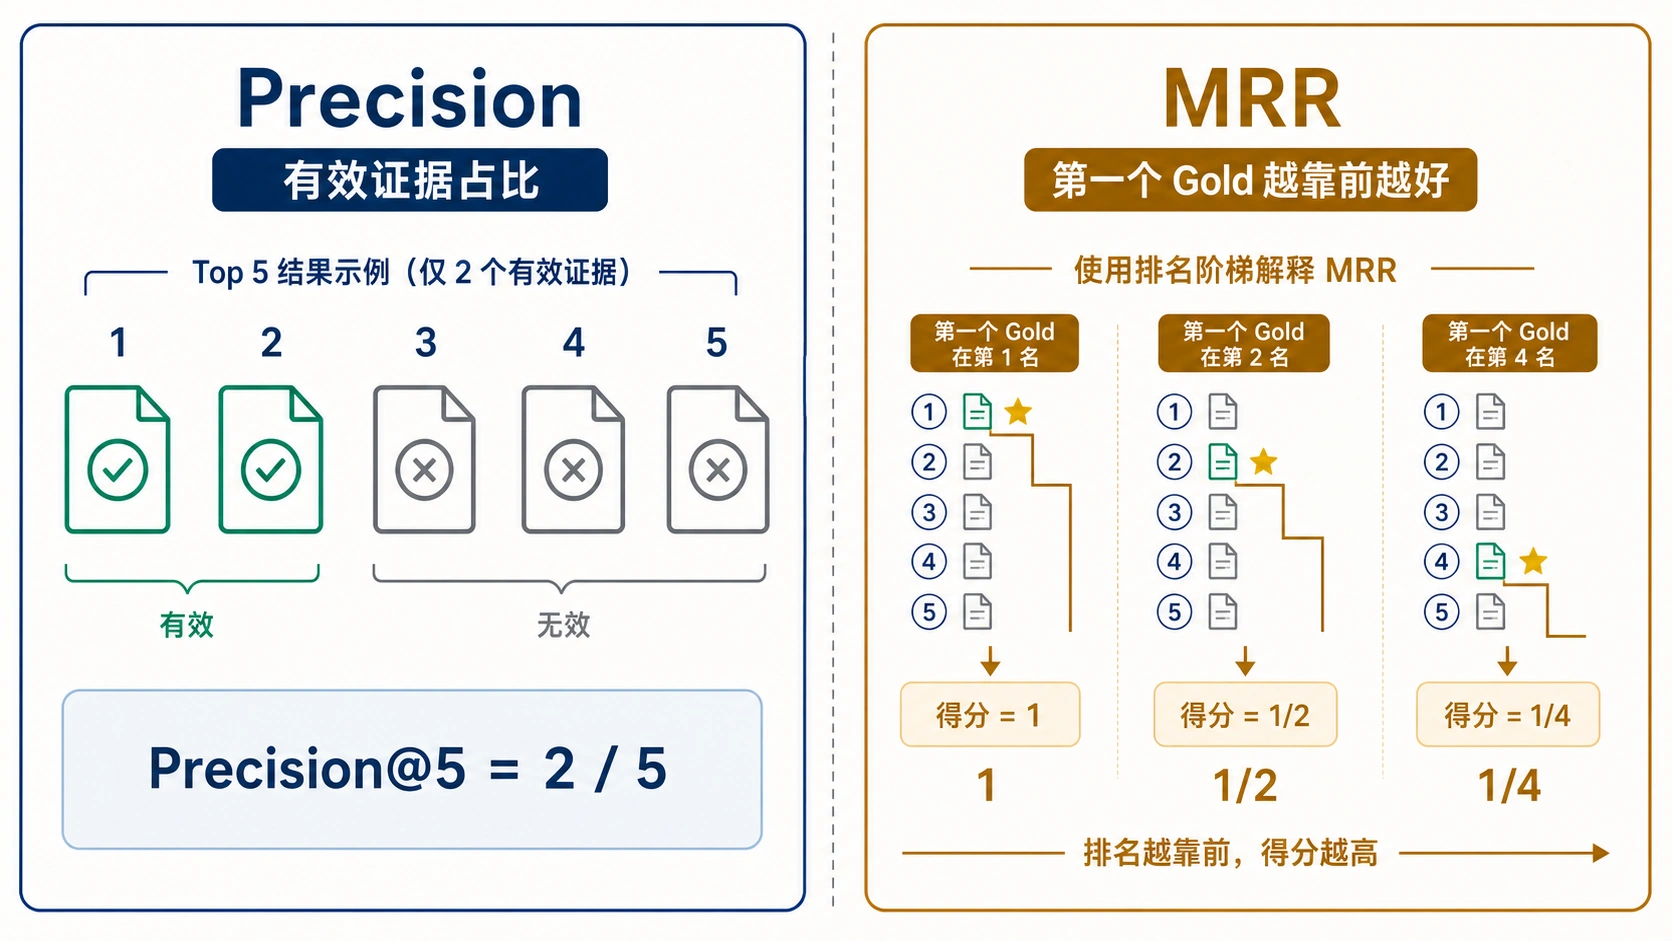
Precision@K = Top K 命中的 Gold 数 / K提高 K 往往会提高 Recall,却会降低 Precision。它验证的是 Context 候选是否被噪声淹没,而不是简单追求越大越好。
本轮 qwen3.7 的 Recall@5 为 0.9606,而 Precision@5 只有 0.2250。这不矛盾:大多数必要证据已经找回,但 Top 5 中仍包含很多不属于严格 Gold 的 Chunk。后续应继续用 Context Precision 判断这些内容是否真的无用,不能只凭检索 Precision 直接删除。
MRR:第一个正确结果排得有多靠前
单题贡献为首个 Gold 排名的倒数:第 1 名是 1,第 2 名是 1/2,第 4 名是 1/4;完全未命中是 0。MRR 是所有可回答问题贡献的平均值。
它适合验证“用户或下游组件多快看到第一个正确入口”。Hit@5 相同的两个系统,首个 Gold 分别位于第 1 和第 5 名,MRR 会明确区分它们。
5. nDCG@K 为什么需要分级相关性
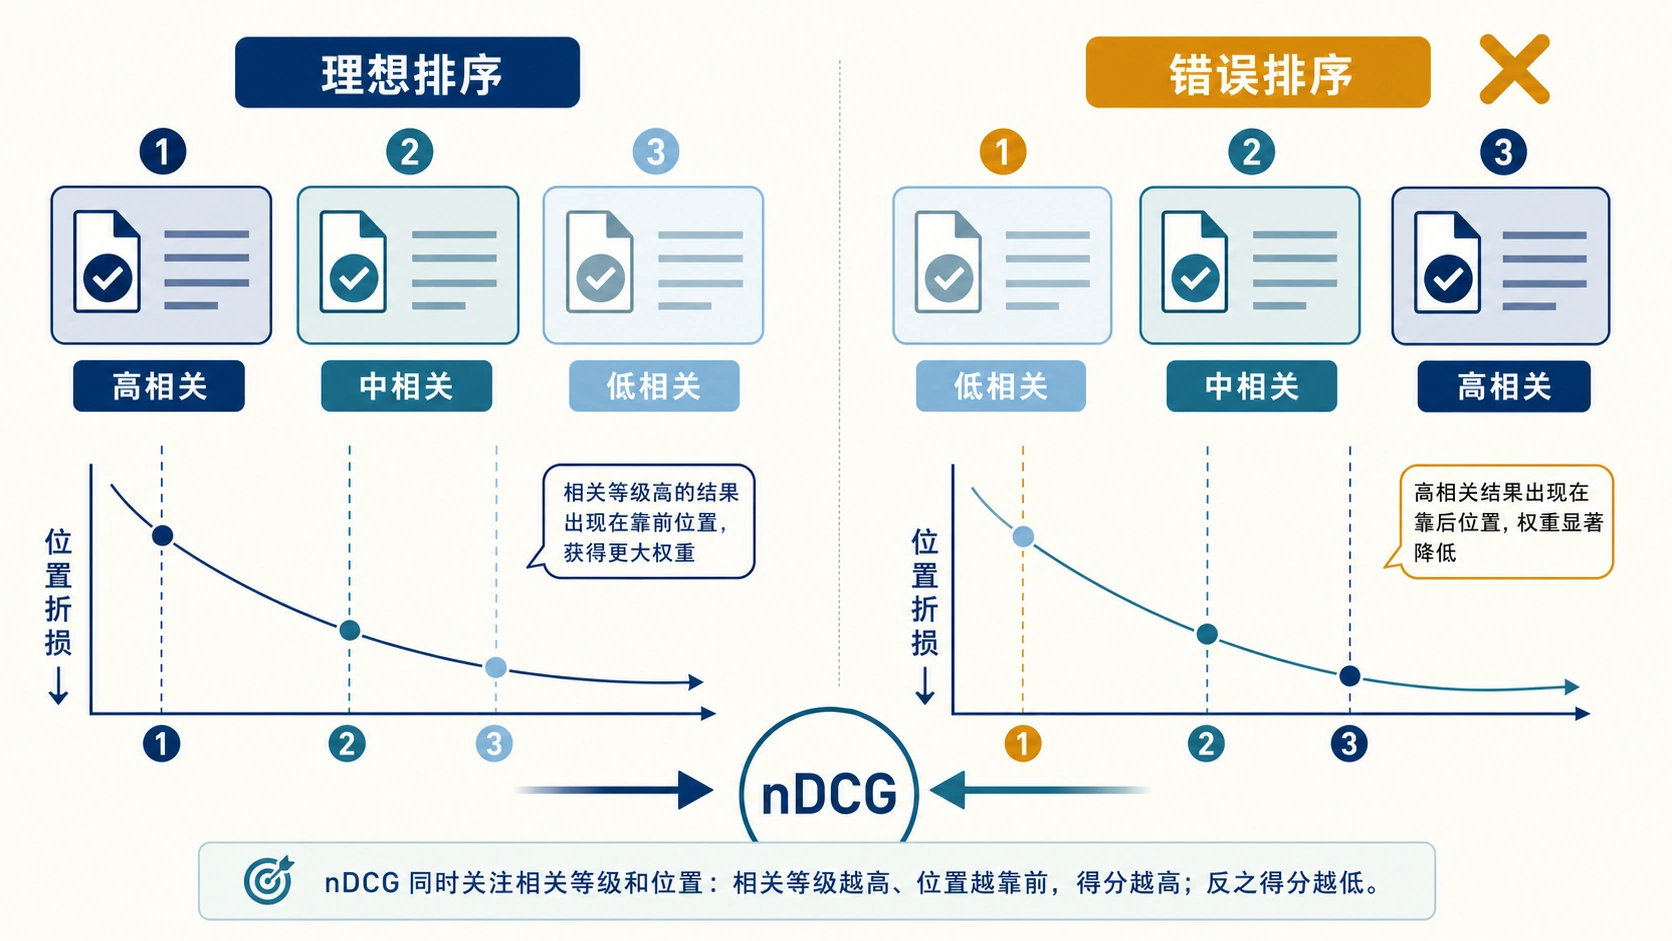
Hit、Recall 和 Precision 通常把结果简化为相关或不相关。但真实检索中,一个 Chunk 可能完整回答,另一个只提供背景,第三个只是主题相似。
nDCG 先根据相关等级计算折损累计增益:
DCG@K = Σ (2^relevance - 1) / log2(rank + 1)
nDCG@K = 实际 DCG / 理想排序 DCG
高相关证据排在前面时更接近 1;相同结果集合顺序不佳时得分下降。它适用于 Reranker 和多级证据排序评测。
但 nDCG 的可信度取决于相关性池是否完整。本轮只使用部分分级标注,尚未对两个模型 Top 5 的并集完成独立 pooled relevance 审核。因此报告明确标记 publishable=false,nDCG 只能作为实验观察,不能作为正式发布结论。这是评测诚实性的一部分。
6. Pairwise 与 Bootstrap 置信区间
Pairwise:逐题比较谁把正确证据排得更前
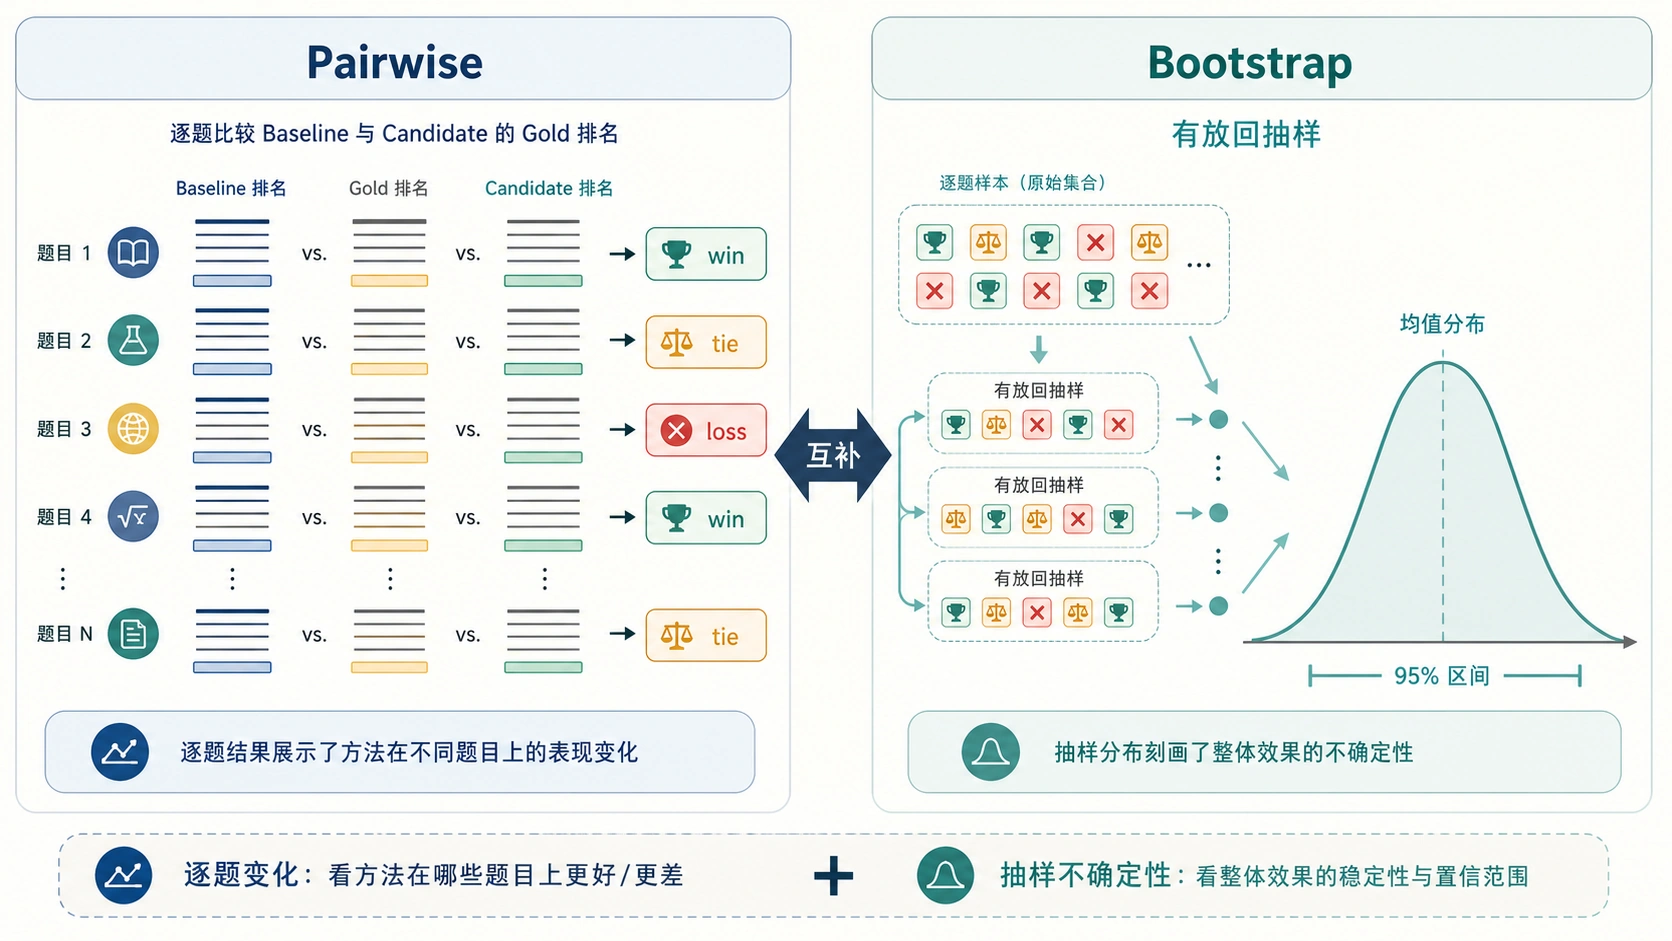
对同一道题比较两个候选方案首个 Gold 的排名:
- Candidate 排名更前:Candidate win;
- Baseline 排名更前:Baseline win;
- 排名相同:tie;
- 都找不到:both miss。
最终 112 道正式检索题中,qwen3.7 胜 22 题、v4 胜 10 题、80 题打平、没有双方都漏掉的题。Pairwise 的价值是提醒我们:总体均值提升不代表每题都提升,10 道退步题仍应保留为回归样本。
Bootstrap:观察均值对题目抽样是否敏感
Bootstrap 从现有逐题结果中有放回抽样,重复计算均值,再取分位区间。它回答的是:如果测试题恰好换一批,当前差异是否可能消失?
它不能修复偏置题集。如果问题类别本身不代表真实流量,再窄的置信区间也只是对错误目标非常确定。因此必须同时报告类别覆盖、样本数、Pairwise 明细和区间。
指标到行动的快速映射
| 现象 | 优先验证 |
|---|---|
| Hit@5 低 | Embedding、标题增强、Hybrid、Chunk 边界 |
| Hit@5 高但 MRR 低 | Reranker、精确词权重、排序特征 |
| Hit 高但 Recall 低 | 多证据检索、Query 分解、扩大候选集 |
| Recall 高但 Precision 低 | Context 去噪、Reranker、动态 K |
| nDCG 低 | 分级相关性排序,但先确认标注池完整 |
| 均值提升但 Pairwise 有退步 | 逐题分析退步类别并设回归门槛 |
| 置信区间很宽 | 增加有代表性的独立问题,而不是重复简单题 |
指标不是替代判断,而是把下一步调查缩小到可验证范围。