本篇回答一个工程问题:两个 Embedding 模型都能运行,怎样判断谁更适合当前真实知识库? 重点评测 Retriever,不把 LLM 的语言风格和随机性混进实验。
1. 为什么“问几个问题感觉不错”不算评测
人工随便问三五个问题,容易受到以下因素影响:
- 只挑了简单问题;
- 只看最终答案是否流畅,没有检查证据是否正确;
- Prompt 或 LLM 同时发生变化;
- 对一个模型使用了更合适的 Chunk 或维度;
- 只报告成功案例,没有记录失败案例。
Benchmark 的价值不是产生一张漂亮分数表,而是建立一个可重复实验:当模型、切块或检索策略变化时, 我们能用同一把尺子判断真实提升与退步。
2. 第一阶段为什么只测 Retriever
完整 RAG 是:
Question → Retrieval → Top K Context → LLM → Answer当前 Benchmark 截止到 Top K:
Question → Embedding → pgvector → Top K → 与人工 Gold 对比暂时不加入 LLM,原因是我们要回答一个单一问题:
Embedding 模型变化后,正确 Chunk 是否排得更靠前?
如果同时比较最终答案,就会混入 LLM 随机性、Prompt 和生成模型能力,无法清楚归因。
3. A/B 测试完整流程
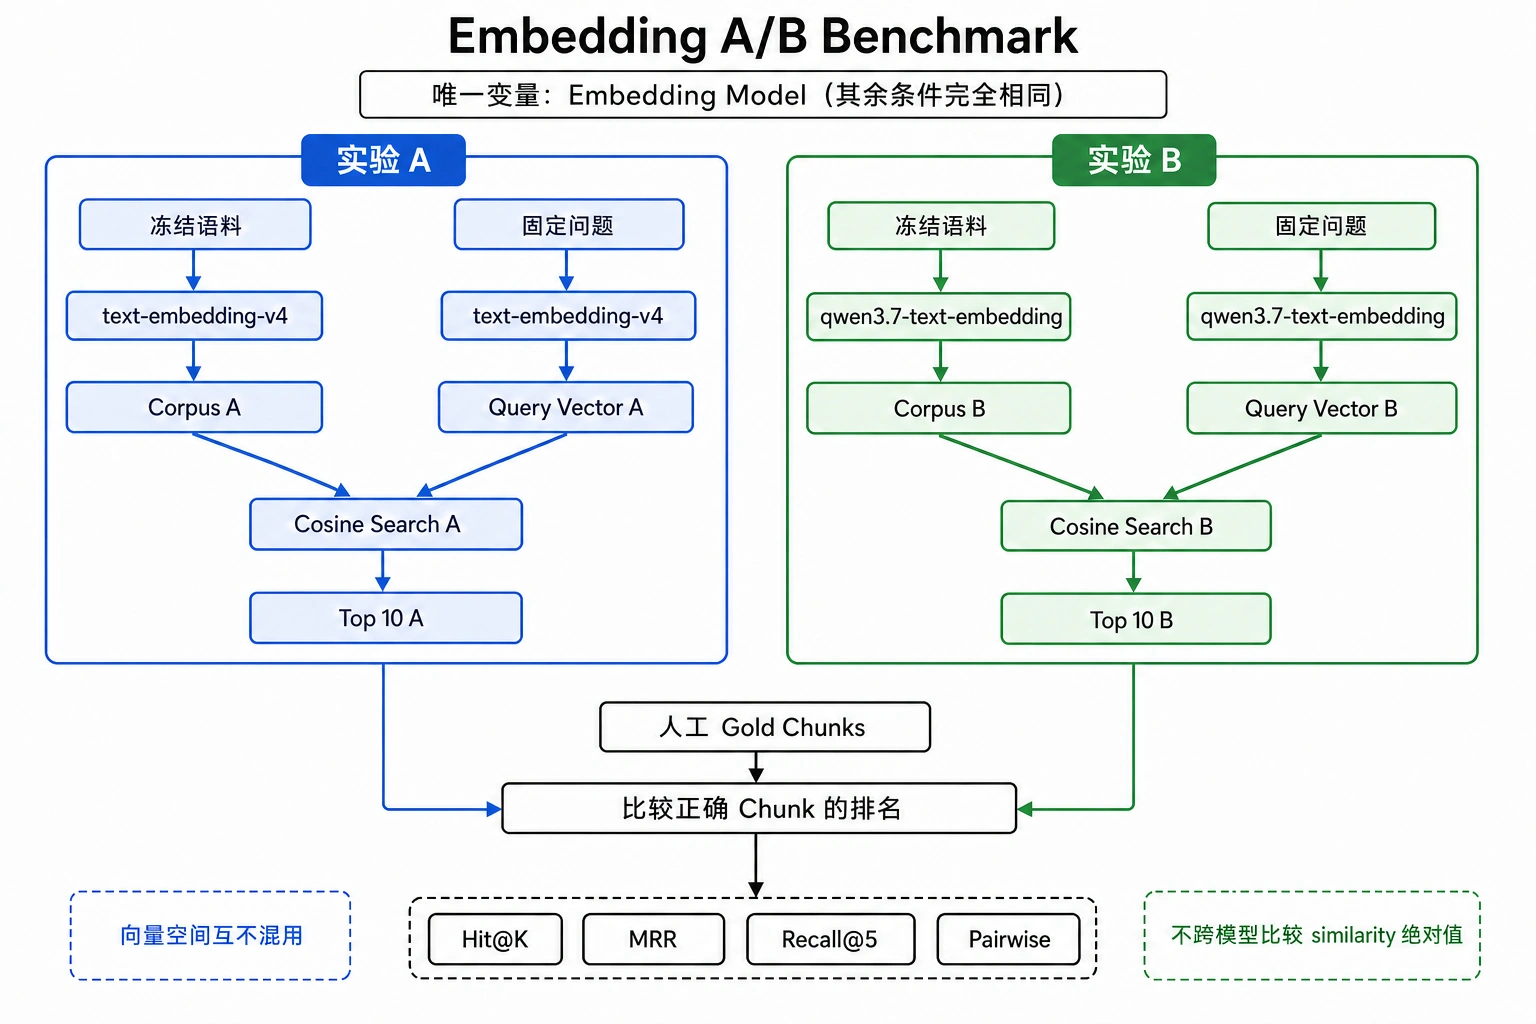
文字版流程:
同一份冻结 Chunk
├── text-embedding-v4       → Corpus A
└── qwen3.7-text-embedding  → Corpus B

同一个 Question
├── 用 v4 生成 Query Vector       → 只搜索 Corpus A → Top 10 A
└── 用 qwen3.7 生成 Query Vector  → 只搜索 Corpus B → Top 10 B

Top 10 A / B
→ 分别与事先标注的 Gold Chunk 比较
→ Hit@K、MRR、Recall@5、Pairwise、Bootstrap
两条实验路径只有 Embedding Model 不同。
4. 公平测试的核心:一次只改变一个变量
本次唯一变量:
Embedding Model以下条件全部冻结:
- Markdown 语料;
- Chunk 算法、Size、Overlap;
- 标题与正文拼接方式;
- Embedding 维度(都为 1024);
- 问题集合与 Gold Chunk;
- 距离度量(cosine);
- PostgreSQL、pgvector 与 SQL;
- 保存的 Top K(10);
- 精确检索,不使用 HNSW / IVFFlat。
如果把 v4/1024 与 qwen3.7/2048 比较,模型和维度同时改变,无法知道提升来自哪里。
5. Benchmark 名词词典
5.1 Benchmark
定义:在固定数据、固定流程和固定指标下,对系统能力进行可重复测量。
本项目中的位置:benchmark/ 目录保存语料快照、问题、两模型结果、指标和失败分析。
5.2 Baseline 与 Candidate
- Baseline(基线):当前参照方案,本项目为
text-embedding-v4。 - Candidate(候选):准备评估的新方案,本项目为
qwen3.7-text-embedding。
基线不是“落后模型”的同义词,它是判断变化是否真正改善的参照物。
5.3 Corpus
定义:参与评测的全部冻结 Chunk 及其 Embedding 输入文本。
本项目在 corpus_chunks.jsonl 中保存 35 篇文档的 1165 个 Chunk。两个模型收到的字符串逐字一致。
5.4 Snapshot
定义:记录一次实验所用语料和参数的快照。
snapshot.json 包含:
- 文档数、Chunk 数;
- Chunk Size、Overlap 和算法;
- 维度、距离、Top K;
- 两个模型名;
- 精确检索说明;
- Snapshot Hash。
Snapshot Hash 是整个冻结语料的指纹。文档或 Chunk 变化后,哈希会变化,旧结果不能再假装来自 同一实验条件。
5.5 Question Set
定义:用于检索评测的问题集合。本项目共 100 题,其中 90 题可回答、10 题不可回答。
问题不能全是原文复述,否则只能证明模型能匹配明显关键词,不能代表真实用户表达。
5.6 Gold Chunk
定义:人工事先确认、确实能够回答某个问题的正确 Chunk。
{
  "id": "Q001",
  "question": "Spring Cache 中缓存多久会失效?",
  "gold_chunk_ids": [128],
  "answerable": true
}
Gold 必须在运行模型之前确定。不能把模型返回的 Top 1 当 Gold,否则模型在用自己的答案给自己判分。
一个问题可以有多个 Gold Chunk,表示完整答案可能由多个片段支持。
5.7 Answerable 与 No Answer
- Answerable:冻结语料中存在能够回答问题的 Chunk。
- No Answer:知识库明确没有答案。
向量搜索无论有没有答案都会返回“最接近”的 Top K。因此 No Answer 主要用于观察错误内容会得到怎样的 相似度,并为未来按模型校准拒答阈值提供数据;它不进入 Hit@K 主指标。
5.8 问题类别
| 类别 | 测什么 | 例子特点 |
|---|---|---|
| Direct | 基本语义检索 | 问法接近原文 |
| Paraphrase | 改写理解 | 不直接复述关键词 |
| Cross Language | 中英混合 | 中文问题含英文类名或术语 |
| Code/API | 精确技术符号 | 类名、命令、配置项、API |
| Hard Negative | 相似主题区分 | 多篇文档都含相同关键词 |
| No Answer | 无答案行为 | 语料中没有相关知识 |
只看 Overall 会掩盖模型到底改善了哪类问题。技术博客尤其需要关注 Code/API 与 Hard Negative。
6. 为什么两个模型必须各搜各的 Corpus
Embedding 模型定义了自己的向量空间:
v4 Query Vector      ↔ v4 Document Vectors
qwen3.7 Query Vector ↔ qwen3.7 Document Vectors
禁止:
qwen3.7 Query Vector → 搜索 v4 Document Vectors即使维度相同,两套坐标也不具有共同语义。benchmark_embeddings 以
(chunk_id, model) 为主键,正是为了让同一 Chunk 同时保存两套独立向量。
7. 为什么保存 Top 10
生产系统可能只把 Top 5 交给 LLM,但 Benchmark 保存 Top 10,便于一次查询后计算:
Hit@1 / Hit@3 / Hit@5 / Hit@10
MRR
Recall@5
如果只保存 Top 1,未来想计算 Hit@5 就必须重新调用查询 API;保存 Top 10 是低成本的实验记录。
8. 指标如何计算
8.1 Hit@K
问题:至少一个 Gold Chunk 是否出现在前 K 名?
假设 Gold 是 Chunk 128,返回排名为:
Rank 1: Chunk 430
Rank 2: Chunk 128  ← Gold
Rank 3: Chunk 900
则:
Hit@1 = 0
Hit@3 = 1
Hit@5 = 1
对所有可回答问题取平均。例如 90 题中有 75 题的 Gold 排第一:
Hit@1 = 75 / 90 = 83.3%Hit@1 强调第一名是否最准确;Hit@5 更接近“Retriever 是否把正确资料交给后续 LLM”。
8.2 MRR
MRR 是 Mean Reciprocal Rank,平均倒数排名。它关心第一个正确结果整体排得多靠前。
第 1 名命中 → 1 / 1 = 1.000
第 2 名命中 → 1 / 2 = 0.500
第 3 名命中 → 1 / 3 = 0.333
Top 10 未命中 → 0
再对全部问题求平均。MRR 比 Hit@5 更能区分“正确资料虽然都在前五,但一个总在第一、另一个总在第五”。
8.3 Recall@5
当一个问题有多个 Gold Chunk 时,Recall@5 衡量前五名找回了多少正确片段。
Gold = {128, 129, 130}
Top 5 = {128, 430, 129, 500, 600}

命中 2 个,共 3 个
Recall@5 = 2 / 3 = 0.667
它与 Hit@5 不同:上例只要命中一个,Hit@5 就是 1;Recall@5 会继续关心是否找全。
8.4 Pairwise Comparison
逐问题比较两个模型第一个 Gold 的排名:
Q017: v4 Rank 7,qwen3.7 Rank 1 → qwen3.7 win
Q025: v4 Rank 1,qwen3.7 Rank 3 → v4 win
Q030: 都是 Rank 1              → tie
Pairwise 能看见整体平均分背后的具体胜负案例,便于继续阅读失败文档。
8.5 Bootstrap 95% CI
当前 90 道可回答问题只是潜在真实问题的一份样本。Bootstrap 会从这 90 题中进行 1000 次“有放回 重采样”,每次重新计算指标,观察结果在不同抽样下有多稳定。
95% CI 可以直观理解为:在当前题集与重采样方法下,指标的主要波动范围。它不是“模型有 95% 概率 正确”,也不能消除题集偏差或 Gold 标注错误。
8.6 P50 与 P95 延迟
- P50:一半请求比这个值快,一半比它慢,接近典型体验。
- P95:95% 请求比这个值快,用来观察较慢的尾部请求。
平均值可能被极慢或极快的少量请求扭曲,故性能报告常同时使用百分位。
9. 为什么不能横向比较两个模型的相似度绝对值
错误结论:
模型 A Top1 similarity = 0.88
模型 B Top1 similarity = 0.82
所以 A 更好
不同模型的向量空间与分数分布不同,0.88 和 0.82 没有统一刻度。可以比较的是:
- 各自空间内正确 Chunk 的排名;
- 同一模型中 Answerable 与 No Answer 的分布;
- 经过每个模型独立校准后的阈值效果。
不能把一个模型的拒答阈值直接复制给另一个模型。
10. 本项目的文件与执行顺序
| 文件 | 作用 |
|---|---|
snapshot.json | 冻结实验条件与语料指纹 |
corpus_chunks.jsonl | 全部 Chunk 和逐字一致的 Embedding 输入 |
questions_*.jsonl | 各类别候选问题 |
questions.jsonl | 合并校验后的统一问题集 |
results_v4.jsonl | v4 每题 Top 10 与延迟 |
results_qwen37.jsonl | qwen3.7 每题 Top 10 与延迟 |
summary.json | 机器可读的指标汇总 |
REPORT.md | 人类可读的整体报告 |
FAILURES.md | 逐问题胜负与失败案例 |
执行顺序:
# 1. 冻结语料、建独立表、生成 Snapshot
./.venv/bin/python -m benchmark.scripts.prepare

# 2. 合并问题并检查 Gold
./.venv/bin/python -m benchmark.scripts.validate_questions

# 3. 分别生成两套 Corpus Embedding
./.venv/bin/python -m benchmark.scripts.embed_corpus both

# 4. 每个问题分别查询两套 Corpus
./.venv/bin/python -m benchmark.scripts.run both

# 5. 计算指标
./.venv/bin/python -m benchmark.scripts.evaluate

# 6. 生成人类可读报告
./.venv/bin/python -m benchmark.scripts.report
11. 当前真实结果怎么读
测试条件:
35 documents / 1165 chunks
100 questions(90 answerable + 10 no-answer)
两个模型均为 1024 维
精确 cosine search
11.1 总体指标
| 指标 | text-embedding-v4 | qwen3.7-text-embedding | 差值 |
|---|---|---|---|
| Hit@1 | 68.9% | 83.3% | +14.4 个百分点 |
| Hit@3 | 94.4% | 98.9% | +4.4 个百分点 |
| Hit@5 | 95.6% | 98.9% | +3.3 个百分点 |
| MRR | 0.811 | 0.907 | +0.096 |
| Recall@5 | 92.7% | 94.9% | +2.2 个百分点 |
“百分点”与“相对提升”不同。68.9% 到 83.3% 是增加 14.4 个百分点,不应含糊写成“提升 14.4%”。
11.2 按类别观察
| 类别 | v4 Hit@1 | qwen3.7 Hit@1 | 观察 |
|---|---|---|---|
| Direct | 90.0% | 85.0% | 简单直接问题略有回退 |
| Paraphrase | 75.0% | 90.0% | 改写问题改善明显 |
| Cross Language | 80.0% | 93.3% | 中英混合改善 |
| Code/API | 60.0% | 86.7% | 技术符号相关问题改善最大 |
| Hard Negative | 40.0% | 65.0% | 相似主题区分改善,但仍最难 |
这比“新模型赢了”更有价值:当前知识库是技术博客,Code/API 和中英混合问题占实际使用的重要部分, 因此这些类别的改善具有业务意义。
11.3 Pairwise
qwen3.7 wins: 21
v4 wins:       6
ties:         63
both miss:     0
大多数问题打平;新模型在 21 个问题上把 Gold 排得更靠前,但也有 6 个问题退步。升级模型不意味着
每一道题都改善,FAILURES.md 中的退步案例应继续保留为回归测试。
11.4 当前可以得出的结论
在这份冻结的技术博客语料、这 100 道题、相同 1024 维和相同精确检索流程下,
qwen3.7-text-embedding 的 Hit@1、MRR,以及 Code/API、改写和中英混合类别表现更好,
因此当前报告建议升级。
11.5 当前不能得出的结论
- 不能推断所有中文 RAG 都会提升 14.4 个百分点;
- 不能推断最终 LLM 答案也会等比例提升;
- 不能说 qwen3.7 每类问题都更好,Direct 类别存在小幅回退;
- 不能把两模型 No Answer 的相似度均值直接比较后定胜负;
- 不能证明当前 Chunk 策略已经最优;
- 不能忽略题集规模、类别比例和 Gold 标注质量。
这就是“局部证据”与“普遍结论”的边界。
12. 如何阅读失败案例
不要只问“哪个模型错了”,应继续分类根因:
| 失败标签 | 含义 | 可能的下一步 |
|---|---|---|
EMBEDDING_SEMANTIC | 改写语义没有靠近正确片段 | 换模型或改输入表示 |
EXACT_TERM | 错误码、参数名等精确词匹配弱 | BM25 / Hybrid Search |
CODE_SYMBOL | 类名、API、命令召回差 | Code 向量模型或稀疏检索 |
CROSS_LANGUAGE | 中英文对应关系差 | 更强多语言模型 |
SIMILAR_TOPIC_CONFUSION | 多篇相似文章难区分 | 标题元数据、Reranker |
CHUNK_BOUNDARY | 答案被切散 | 调整 Chunk/Overlap |
INSUFFICIENT_CONTENT | 原文就没有完整答案 | 补充知识库 |
AMBIGUOUS_QUERY | 问题本身含义不清 | Query Rewrite / 追问 |
如果两个模型都失败,问题不一定在 Embedding。先检查 Gold、原文、Chunk 边界和问题表达,再决定 是否引入新组件。
13. Benchmark 为什么也是回归测试
以后任何改动都可能让部分问题变好、另一些变差:
- 更换 Embedding;
- 调整 Chunk Size / Overlap;
- 加标题或元数据;
- 引入 BM25 / Hybrid;
- 加 Reranker;
- 改查询重写策略。
保持同一 Question Set 与 Gold,可以比较修改前后指标和逐问题排名。Benchmark 因而不只是一次模型 选型报告,也是 RAG 的 Regression Test Suite(回归测试集)。
但只要语料或切块发生变化,就必须生成新 Snapshot,并认真处理 Chunk ID 与 Gold 的变化。
14. 初学者常见误区
- 只看最终答案评分 Embedding。 LLM 会掩盖或放大检索问题,应先单独测 Retriever。
- 只看 Hit@5。 两模型都接近满分时,Hit@1 和 MRR 更能看出排序差异。
- 把模型自己的结果当 Gold。 这会形成自证循环。
- 跨模型比较 similarity。 两个向量空间没有统一分数刻度。
- 同时改模型、维度和 Chunk。 无法归因提升来源。
- 只报告 Overall。 必须按类别和逐问题检查改善与退步。
- 忽略 No Answer。 向量数据库永远会返回最近结果,最近不代表有答案。
- 把一次 Benchmark 当永久真理。 语料、用户问题和业务目标变化后需要重新评测。
15. 自测题
- 为什么本 Benchmark 不把 LLM 最终回答纳入主测试?
- 什么是 Gold Chunk,为什么必须在运行模型之前确定?
- Hit@5=1 能否说明多个 Gold 都找全了?为什么?
- 一个问题的首个 Gold 在第 4 名,它对 MRR 的贡献是多少?
- 为什么两个 1024 维模型的向量仍然不能混用?
- 为什么不能用 0.88 与 0.82 的相似度直接判断两个模型谁更好?
- 当前结果支持什么结论,又不支持什么结论?
- Code/API 问题持续失败时,为什么 BM25 可能比继续增大向量维度更值得研究?
能解释这些问题,你已经从“会运行 RAG”迈向“能判断 RAG 为什么好或不好”。