这是「基础知识填坑系列」的第 1 篇。这一篇把 Java 里最常用的一批数据结构——数组、链表、HashMap、BST、AVL、红黑树——重新串成一条线,重点不是背结论,而是理解每种结构 ” 为什么存在 ”。
我以前学习数据结构时,很容易陷入一种状态:知道 ArrayList、LinkedList、HashMap,也背过 O(1)、O(n)、红黑树,但这些知识在脑子里是散开的。
后来我换了一个角度:不要先问 ” 这个结构是什么 “,而要先问 ” 它为什么要这样摆数据,它究竟想让哪一种操作变快 ”。
这篇文章按这条思路,从数组一路推到红黑树。
数据结构,本质上是在 ” 查询、插入、删除、顺序、关系、空间 ” 之间做取舍。
1. Array / ArrayList:用连续槽位换快速定位
数组最核心的能力不是 ” 可以存很多元素 “,而是:
知道下标,就能直接定位。
抽象地看:
index:   0      1      2      3      4
       ┌─────┬─────┬─────┬─────┬─────┐
       │ ref │ ref │ ref │ ref │ ref │
       └─────┴─────┴─────┴─────┴─────┘
对于固定大小的数组槽位,可以通过类似下面的关系定位:
目标位置 ≈ 起始位置 + index × 槽位大小所以随机访问是 O(1)。
1.1 Java 的 ArrayList 连续的是什么?
一个重要修正是:对于 ArrayList<User>,不要想成所有 User 对象都紧挨着摆在一起。
OpenJDK 中 ArrayList 的核心缓冲区是:
transient Object[] elementData;也就是说,更准确的模型是:
ArrayList

┌────────┬────────┬────────┬────────┐
│ ref A  │ ref B  │ ref C  │ null   │
└───┬────┴───┬────┴───┬────┴────────┘
    │        │        │
    ▼        ▼        ▼
 Object A  Object B  Object C
连续的是引用槽位;对象本身由 JVM 管理。
因此 ArrayList 扩容时,扩的是 backing array。旧数组中的引用会被复制到一个更大的新数组中,但被引用的对象本身并不会因为 ArrayList 扩容而重新创建。
这也解释了它的取舍:
- 按下标查询:
O(1) - 尾部追加:通常很快
- 中间插入 / 删除:需要搬动后续引用,
O(n)
所以可以把 ArrayList 记成一句话:
ArrayList 用连续引用槽位换取快速随机访问。
2. LinkedList:不要求连续,用连接关系换局部插删
如果数组的问题是 ” 中间插入需要搬家 “,一个自然的想法就是:
数据为什么一定要连续放?
链表让每个节点保存 ” 下一个节点在哪里 “。双向链表再多保存一个 ” 上一个节点在哪里 ”。
null ← A ⇄ B ⇄ C ⇄ D → null如果已经拿到了 B 和 C,在中间插入 X:
原来:B ⇄ C

变成:B ⇄ X ⇄ C
修改的是固定数量的引用,因此这一步本身是 O(1)。
2.1 为什么 LinkedList 查询是 O(n)?
因为它没有数组那种:
base + index × size的直接定位能力。
如果要找第 500000 个节点,只能:
head → node1 → node2 → node3 → ... → node500000所以最坏是 O(n)。
这里有一个非常重要的前提:
” 链表插入删除 O(1)” 指的是已经拿到目标节点时。
如果代码是:
list.add(500000, value);仍然要先花 O(n) 找到位置,再做 O(1) 的引用修改,所以整体仍是 O(n)。
因此我现在会这样区分:
ArrayList:位置重要,直接定位快
LinkedList:连接重要,局部改关系快
3. Stack、Queue、Deque:重点不是怎么存,而是怎么使用
Array / LinkedList 主要解决数据怎么摆,而 Stack / Queue 更像是在数据结构之上增加操作规则。
Stack:后进先出
进入:main → A → B → C
退出:C → B → A → main
这正好符合函数调用的嵌套关系,因此 Stack 很适合:
- 函数调用
- 递归
- DFS
- Undo / 回退
- 括号匹配
Queue:先进先出 + 缓冲
Queue 不只是 ” 排队 “,后端工程里更重要的是:
让生产者和消费者不必完全同步。
Producer  ──▶  Queue  ──▶  Consumer
10000/s                  5000/s
短时间的速率差可以由 Queue 缓冲,避免流量直接打到下游。
当然,如果生产长期比消费快,Queue 最终还是会积压。它解决的是时间解耦,不是凭空创造处理能力。
Deque:两端都能操作
双端队列允许:
Head                  Tail
 ↓                      ↓
┌───┬───┬───┬───┬───┐
│ A │ B │ C │ D │ E │
└───┴───┴───┴───┴───┘
 ↑                      ↑
都可加入 / 删除
Java 的 ArrayDeque 通过数组 + head/tail 下标 + 循环利用空间,可以同时模拟 Stack 和 Queue。
4. HashMap:给 Key 算出一个 ” 接近直接定位 ” 的下标
数组的随机访问很快,但前提是我知道下标。
现实里我们更常见的需求是:
userId → User
configKey → Config
orderId → Order
我知道的是 Key,不是数组 index。
HashMap 的核心思路就是:
Key
 ↓
hash
 ↓
计算 bucket index
 ↓
Node[] table[index]
因此可以把 HashMap 理解成:
你给我 Key,我把它转换成数组下标。
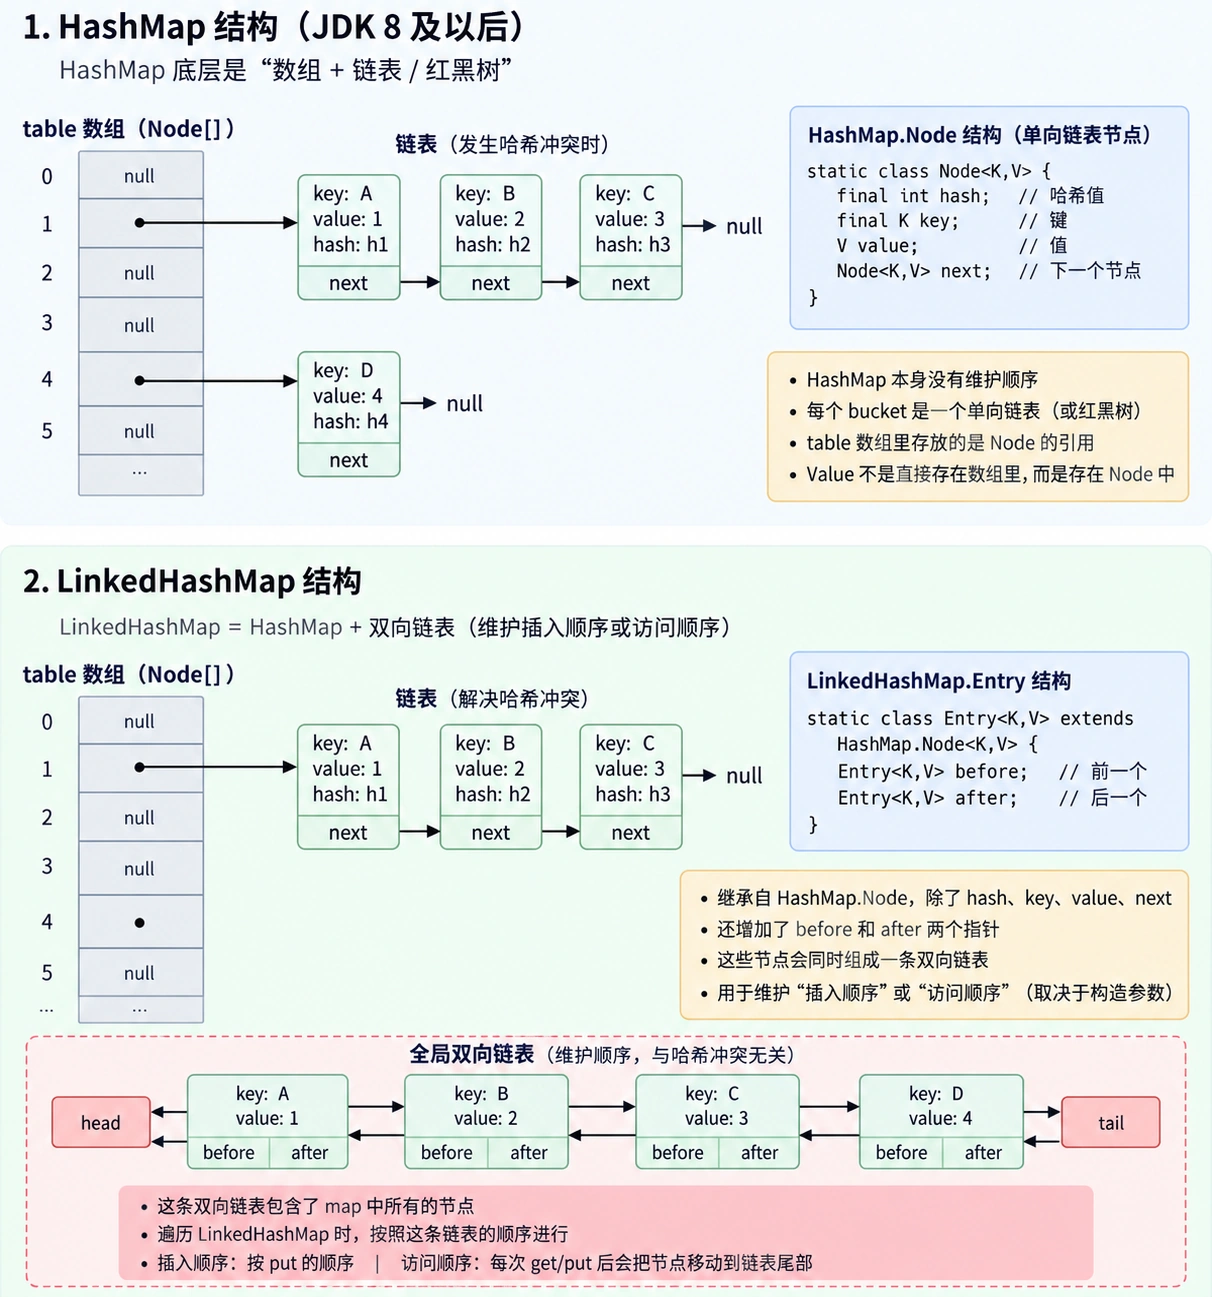
4.1 HashMap 存的不是 Value 本身,而是 Node
当前 OpenJDK 中,普通 bucket 节点的核心结构可以简化成:
static class Node<K,V> {
    final int hash;
    final K key;
    V value;
    Node<K,V> next;
}
所以底层更像:
Node[] table

0  null
1  ──▶ Node(A) → Node(B) → Node(C)
2  null
3  ──▶ Node(D)
table[index] 保存的是 bucket 首节点引用;发生哈希碰撞时,再通过 next 形成链。
5. 为什么 HashMap 平均查询是 O(1),冲突后会变慢?
理想情况:
key
 ↓
hash
 ↓
index
 ↓
Node
直接命中一个 bucket,接近 O(1)。
但两个 Key 可能算到同一个 bucket:
bucket 5
  ↓
Node A → Node B → Node C
此时查询需要在 bucket 内继续比较 hash + equals。
假设整个 HashMap 有 N 个元素,而当前 bucket 有 k 个节点,那么链表 bucket 内查找是 O(k),极端情况下 k≈N,就会退化成 O(n)。
因此 JDK 8+ 的 HashMap 在特定条件下会把长链表转换为红黑树,使 bucket 内的最坏查找从线性量级改善为 O(log k)。
当前 OpenJDK 中几个值得记住的阈值是:
TREEIFY_THRESHOLD    = 8
UNTREEIFY_THRESHOLD  = 6
MIN_TREEIFY_CAPACITY = 64
这意味着 ” 达到 8 就无脑树化 ” 并不准确:如果 table 本身还比较小,会优先考虑扩容,把节点重新分散;只有容量达到条件后才树化。
为什么不是 3 个节点就树化?
因为 Big O 不是全部。
链表节点简单、内存占用低、常数成本小;红黑树节点要维护更多关系,旋转、变色也有额外维护成本。数据很少时,直接走几步链表往往比建立一棵树更划算。
所以这是典型的工程取舍:
小规模用简单结构,冲突严重时才用复杂结构换更好的增长曲线。
6. 为什么 HashMap 容量喜欢用 2 的幂?
这是我理解 HashMap 时最有意思的一部分。
假设数组长度:
n = 8 = 1000₂
n-1 = 7 = 0111₂
n-1 形成了一个低位全为 1 的天然 mask。
于是:
index = hash & (n - 1);例如 hash = 13 = 1101₂:
  1101
& 0111
------
  0101 = 5
对于 n = 2^k,这个操作等价于保留 hash 的最低 k 位,因此可以高效地完成 bucket 定位。
6.1 扩容为什么只会 ” 原位置 ” 或 ” 原位置 + oldCap”?
从 8 扩到 16:
旧 mask:0111
新 mask:1111
         ↑
只多看了一位
例如:
5  = 0101
13 = 1101
容量为 8 时,两者都只看低 3 位:
5  → 101 = 5
13 → 101 = 5
所以发生碰撞。
容量扩到 16 后,多看一位:
5  → 0101 = 5
13 → 1101 = 13
于是原来的 bucket 被拆开。
因此扩容时,每个旧 bucket 的节点只需要根据 ” 新增加参与 index 计算的那一位 ” 判断:
新 bit = 0 → 留在原 index
新 bit = 1 → newIndex = oldIndex + oldCap
从 8 → 16 → 32,本质上就是不断让 hash 的更多二进制位参与 bucket 定位。
7. 为什么默认 Load Factor 是 0.75?
HashMap 不会等 table ” 彻底挤满 ” 再扩容,因为元素越多,碰撞概率通常越高。
但也不能太早扩容,否则数组会长期非常空,浪费空间。
所以负载因子是在做:
更低:冲突少,但浪费内存、扩容频繁
更高:空间利用率高,但冲突更多
默认 0.75 是时间与空间之间的工程折中。
例如容量 16:
threshold ≈ 16 × 0.75 = 12当元素数量越过阈值后进入扩容流程。
这里要注意:
size / capacity = 0.75不等于 “75% 的 bucket 都被占用 ”。
因为多个元素可能碰撞在同一个 bucket 中。
8. LinkedHashMap:在 HashMap 的节点上,再加一条全局双向链表
HashMap 的核心目标是快速定位,它不负责提供 ” 插入顺序 ” 这样的遍历语义。
LinkedHashMap 的思路非常直接:
HashMap 负责找,双向链表负责顺序。
OpenJDK 中它的 Entry 继承 HashMap.Node,并增加:
Entry<K,V> before;
Entry<K,V> after;
因此同一个节点同时属于两种关系:
关系 1:Hash bucket
A → C → D

关系 2:全局顺序链表
A ⇄ B ⇄ C ⇄ D
这条全局双向链表和 ” 某个 bucket 是否发生哈希碰撞 ” 是两回事。
因此 LinkedHashMap 可以在保留 HashMap 查询能力的同时,维护插入顺序或访问顺序,这也是实现 LRU 类缓存时常见的基础结构。
从 HashMap 走向 Tree:为什么树能提高查询效率?
HashMap 让我理解了 O(1) 的 ” 近似直接定位 ”。
Tree 则是另一种思想:
我不一定一步找到,但每比较一次,就排除大量不可能的数据。
9. 普通二叉树不等于查询快
普通 Binary Tree 只要求:
每个节点最多两个孩子。
       A
      / \
     B   C
    / \
   D   E
它并没有规定大小关系。
所以只知道 ” 这是二叉树 “,并不能推出查找是 O(log n)。
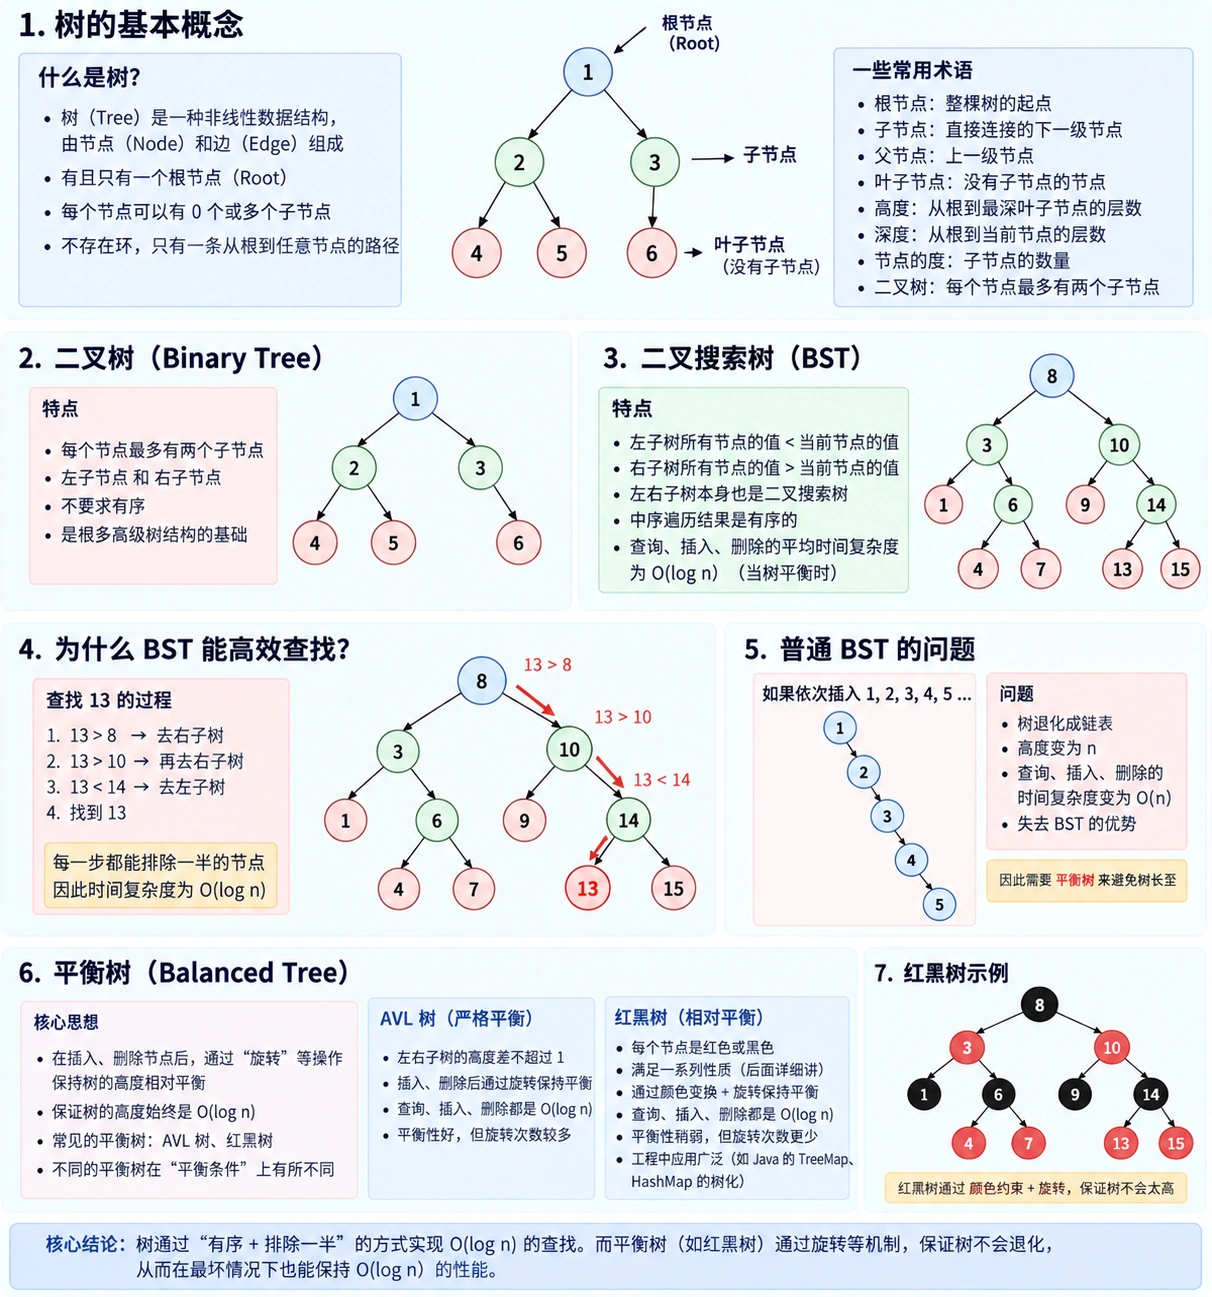
真正产生搜索能力的是 Binary Search Tree(BST,二叉搜索树)。
10. BST:真正重要的是 ” 有序规则 ”
BST 增加:
左子树 < 当前节点 < 右子树例如:
                 8
            /         \
           4           12
         /   \        /   \
        2     6      10    14
       / \   / \    / \    / \
      1  3  5  7   9  11  13 15
查找 13:
13 > 8  → 整个左子树排除
13 > 12 → 再排除一部分
13 < 14 → 走左边
找到 13
所以 BST 查询快的原因不是 ” 它长得像树 “,而是:
每一次比较都能排除一整棵子树。
如果树足够平衡,高度约为 log n,查询就是 O(log n)。
11. BST 最大的问题:它会长歪
依次插入:
1, 2, 3, 4, 5普通 BST 完全可能变成:
1
 \
  2
   \
    3
     \
      4
       \
        5
它依然满足 BST 的大小关系,但已经退化成链表。
所以更准确地说,BST 查找复杂度首先是:
O(height)只有当 height ≈ log n 时,才是我们想要的 O(log n)。
于是出现了 ” 平衡树 ”:
BST 负责有序;平衡算法负责别让树长得太高。
12. 左旋、右旋到底在做什么?
旋转最关键的思想是:
改变局部父子关系,但不能破坏 BST 的中序有序性。
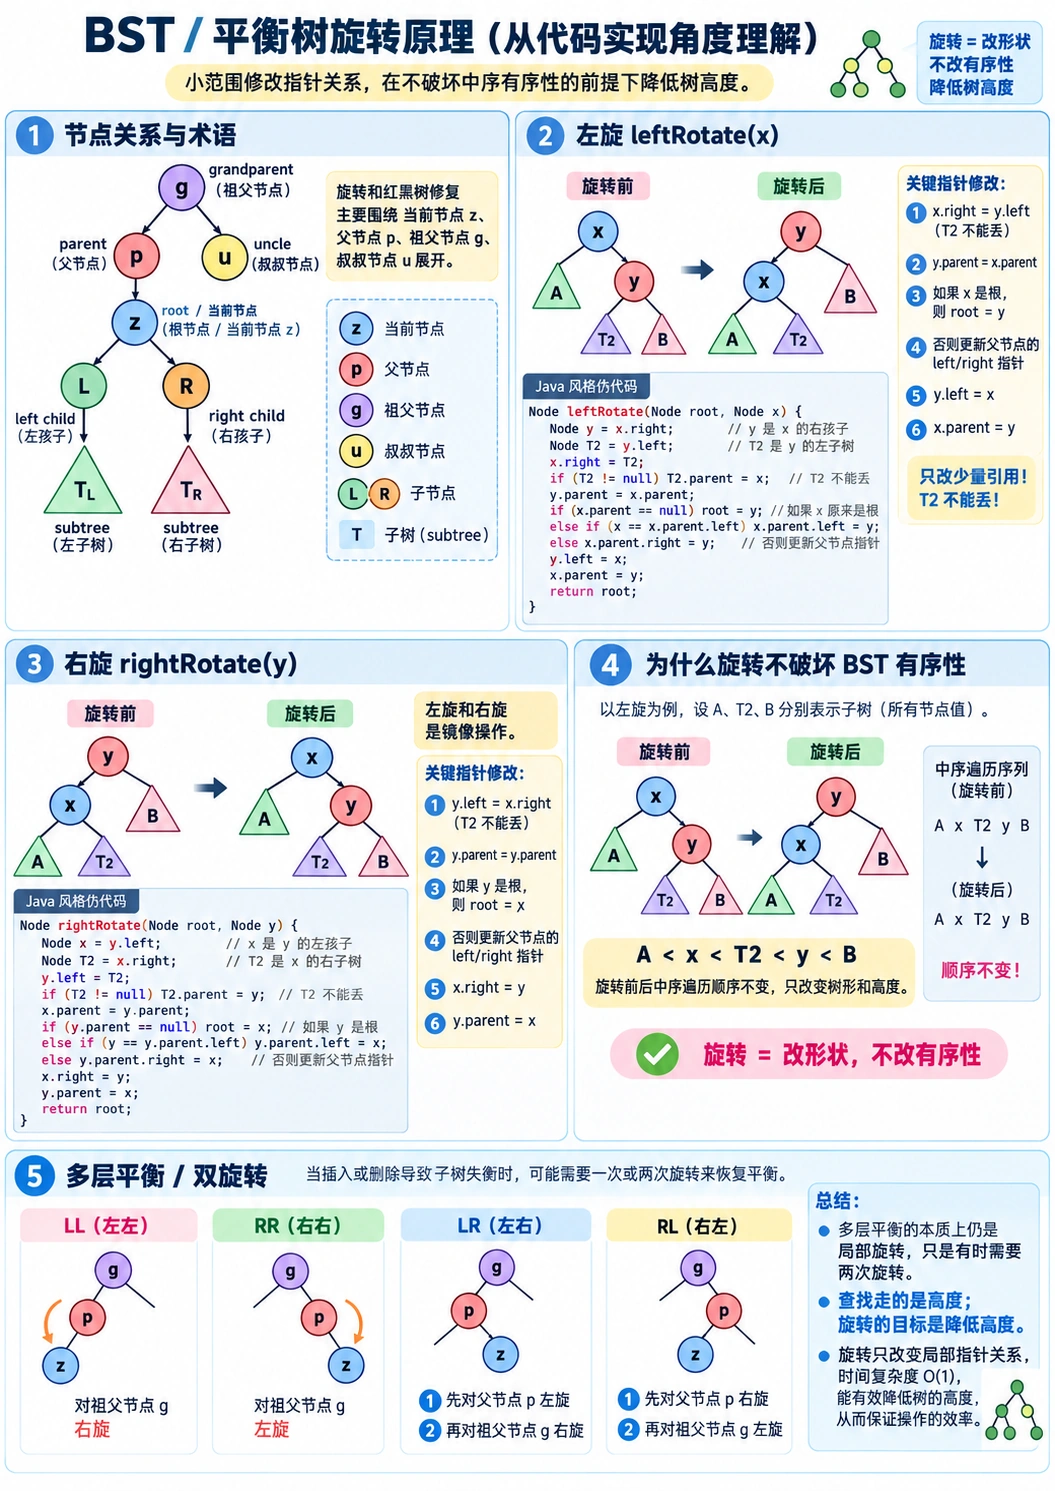
例如右侧太重:
10
  \
   20
     \
      30
对 10 左旋:
      20
     /  \
   10    30
10 < 20 < 30 的顺序没有改变,但高度降低了。
代码层面,本质就是修改少量引用:
void leftRotate(Node x) {
    Node y = x.right;

    x.right = y.left;
    if (y.left != null) {
        y.left.parent = x;
    }

    y.parent = x.parent;

    if (x.parent == null) {
        root = y;
    } else if (x == x.parent.left) {
        x.parent.left = y;
    } else {
        x.parent.right = y;
    }

    y.left = x;
    x.parent = y;
}
所以旋转不是 ” 重新排序整棵树 “,而是局部换根。
13. AVL:严格控制高度差
AVL 是一种严格的平衡 BST。
核心要求可以理解为:
|左子树高度 - 右子树高度| <= 1一旦明显失衡,就通过 LL / RR / LR / RL 等旋转恢复。
因此 AVL 的目标更接近:
尽量把树保持得矮且匀。
它的查询性能很好,但插入、删除时对高度变化比较敏感,维护动作也可能更多。
红黑树:不是追求 ” 绝对平衡 “,而是追求 ” 足够平衡 ”
这是整篇文章里我最容易误解的一部分。
我最初会想:
第一层黑
第二层红
第三层黑
第四层红
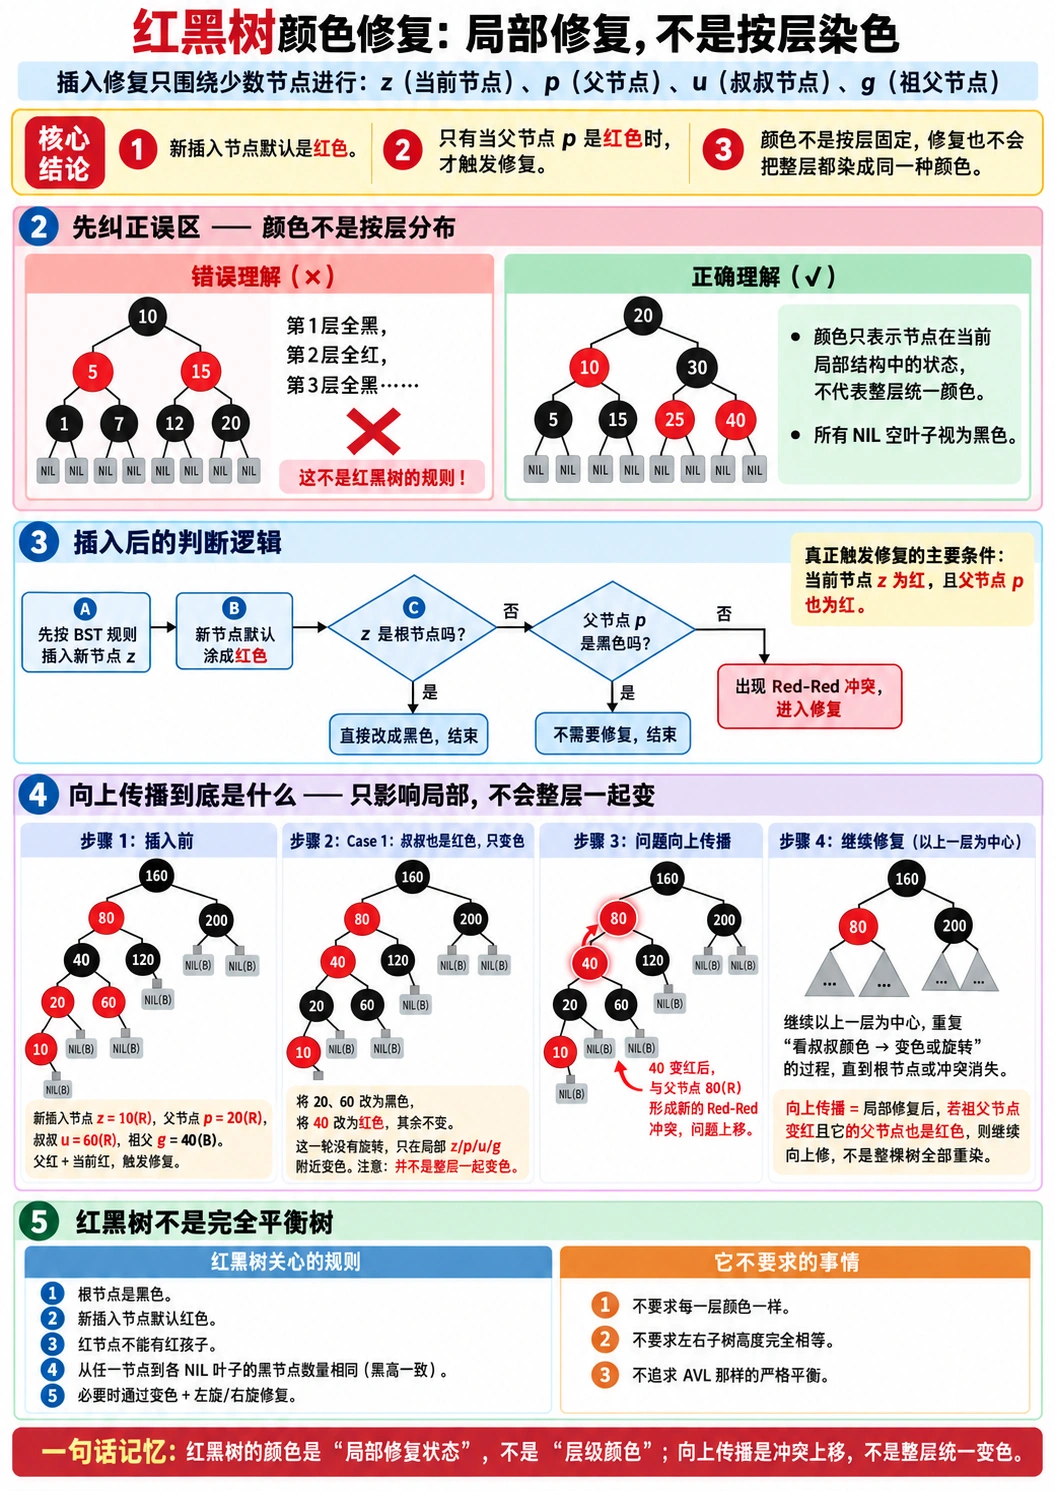
但红黑树完全不是按层染色。
颜色是节点的局部状态,不是层级颜色。
14. ” 叶子节点是黑色 ” 到底是什么意思?
红黑树规则中的 ” 叶子为黑 “,通常指的是理论上的 NIL 空叶子,不是说最后一层所有真实数据节点都必须是黑色。
例如:
        10(B)
       /     \
     5(R)   15(R)
完全可以合法。
如果把 NIL 展开:
            10(B)
          /       \
       5(R)       15(R)
      /   \       /   \
   NIL(B) NIL(B) NIL(B) NIL(B)
这就解释了为什么 ” 根黑、NIL 黑 ” 和 ” 新插入节点默认红色 ” 并不矛盾。
15. 红黑树真正限制的是什么?
红黑树仍然首先是 BST,所以:
左 < 根 < 右仍然是搜索能力的来源。
在此基础上增加颜色约束,其中最值得理解的是两件事:
- 红节点不能直接连接红孩子。
- 从某个节点到下面 NIL 的路径,黑节点数量要保持一致(黑高一致)。
这意味着它允许:
黑 → 红 → 黑 → 红 → 黑但不允许:
黑 → 红 → 红 → 红 → 黑因此最长路径不会无限拉长。
红黑树不要求左右子树高度完全相等,而是通过颜色规则保证高度仍然是 O(log n)。
这就是它和 AVL 最本质的区别:
AVL:高度平衡更严格
红黑树:允许适度不平衡,只要不破坏红黑约束
16. 为什么新节点默认插入红色?
假设插入一个黑节点,会直接让所在路径多一个黑节点,很容易破坏黑高一致。
而插入红色:
黑节点数量暂时不变所以修复成本通常更低。
因此插入过程可以抽象成:
BST 规则插入
↓
新节点先标 Red
↓
如果是 root → 改 Black
↓
如果 parent 是 Black → 合法,结束
↓
如果 parent 也是 Red → 出现 Red-Red 冲突
↓
进入修复
这里需要特别纠正一个误区:
红黑树不是 ” 先完成颜色修复,再统一旋转 ”。
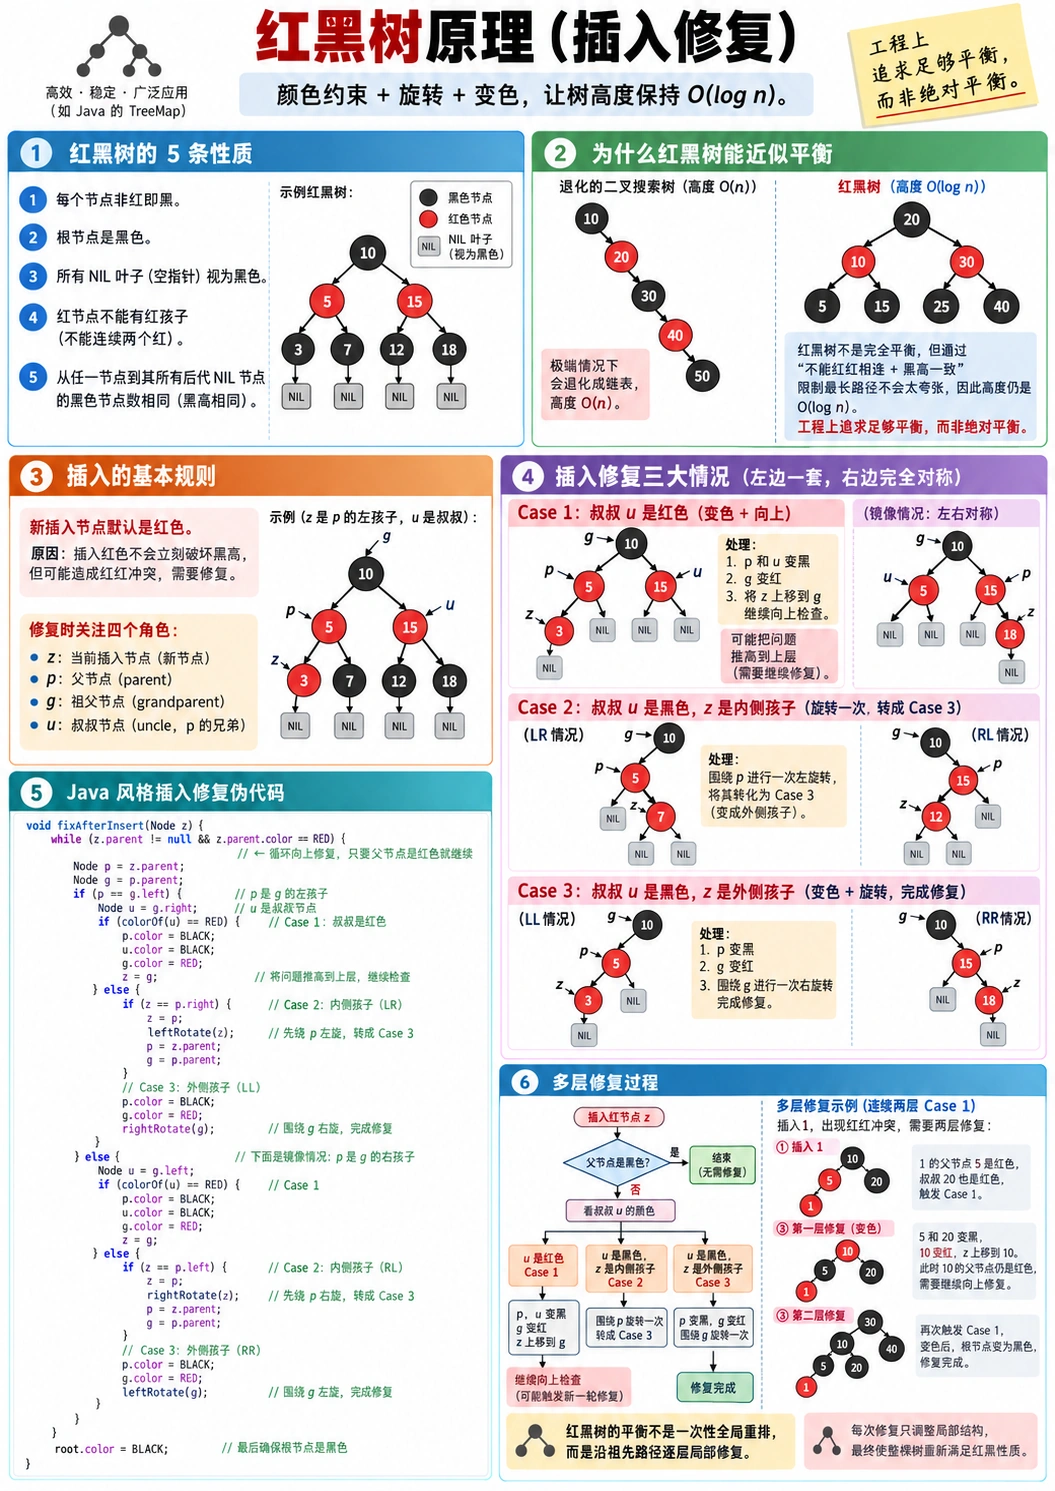
它是 Case 驱动的循环修复:根据父节点、叔叔节点、祖父节点的颜色和位置,决定这一轮只变色,还是变色 + 旋转。
17. 插入修复:叔叔红,通常先变色
设:
z = 当前节点
p = parent
u = uncle
 g = grandparent
如果 z 和 p 都是红色,同时叔叔 u 也是红色:
          g(B)
         /    \
       p(R)   u(R)
       /
     z(R)
可以做:
p → Black
u → Black
g → Red
这相当于把 ” 黑色配额 ” 从祖父下放给父亲和叔叔,局部树形甚至不用改变。
如果 g 变红以后,又和它自己的红色父节点产生冲突,那么问题会继续向上传播。
所以所谓 ” 多层修复 ” 不是整棵树一起重新染色,而是:
局部修好后,如果冲突被推到上一层,就以新的局部为中心继续修。
18. 叔叔黑:才会根据 LL / RR / LR / RL 旋转
例如:
10(B)
   \
   20(R)
      \
      30(R)
这是 RR,并且叔叔为黑(NIL 也算黑)。
此时需要变色 + 对祖父左旋:
       20(B)
      /     \
   10(R)   30(R)
如果结构是折线:
      10
      /
    5
     \
      7
属于 LR:先对 parent 左旋,把折线掰直,再对 grandparent 右旋。
因此红黑树与 AVL 的旋转动作本身并没有一种 ” 红黑树专属版本 ”。
区别在于触发旋转的判定规则不同。
AVL 更关注高度差;红黑树关注红红冲突与黑高约束。
19. 为什么红黑树不追求完全平衡?
因为 ” 更平衡 ” 本身也是有维护成本的。
可以这样理解:
AVL:
“只要高度差明显,我就要调整。”

红黑树:
“有一点歪没关系,只要还满足我的规则。”
因此红黑树允许树比 AVL 稍高,但减少了为了维持严格高度平衡而产生的维护动作。
目标不是获得数学意义上最矮的树,而是:
用较低的维护成本,保证树的高度仍然受控在 O(log n)。
这也是为什么红黑树非常适合作为工程中的通用平衡搜索树。
20. 红黑树删除:从 “Red-Red” 切换为 ” 黑高欠债 ”
插入时,新节点默认红色,因此主要修的是:
Red → Red删除则不同。
如果删的是红节点,通常不会改变黑高;如果删除一个黑节点,就可能让某条路径突然少一个黑节点。
理解删除时,可以使用一个并非真实颜色、但很有帮助的概念:
Double Black意思不是代码里真的多一种颜色,而是:
这里暂时 ” 欠一个黑色 ”。
然后根据 sibling 以及 sibling 的孩子颜色,选择变色、旋转,或者把这个 ” 欠债 ” 继续向 parent 上传。
因此我会把红黑树修改操作压缩成:
插入:主要修 Red-Red
删除:主要修 Black Height
这比背大量 Case 更容易建立整体模型。
21. 最终把这些结构放到同一张脑图里
学完这一轮以后,我不再把它们当作互相独立的名词,而会这样理解:
Array / ArrayList
│
├─ 连续槽位
├─ index 直接定位
└─ 随机访问 O(1)

LinkedList
│
├─ 节点通过引用连接
├─ 找节点 O(n)
└─ 已知节点后的局部插删 O(1)

HashMap
│
├─ hash 把 Key 转换成数组 bucket
├─ 平均查询接近 O(1)
├─ collision → 链表
├─ 长链表 → 红黑树
└─ resize 利用 2 的幂不断解锁更多 hash bit

BST
│
├─ 左 < 根 < 右
├─ 每次比较排除一整片数据
└─ 但可能退化成链表

AVL
│
├─ BST
└─ 严格控制高度差

Red-Black Tree
│
├─ BST
├─ 颜色不是按层分布
├─ 允许适度不平衡
├─ 变色 + 局部旋转
└─ 保证高度仍为 O(log n)
如果再压缩成一句话:
数组解决 ” 位置 “;链表解决 ” 连接 “;HashMap 解决 “Key 到位置的映射 “;BST 解决 ” 有序查找 “;平衡树解决 “BST 会长歪 “;红黑树则是在查询性能和维护成本之间做了非常典型的工程折中。
这也是这一轮重新学习数据结构后,我认为最值得留下来的认知。
参考源码
本文示意图来自本次学习过程中生成的原创教学图;Java 实现细节参考当前 OpenJDK 主干源码: