最近越来越强烈地感觉到一件事:
AI Coding 真正需要优化的,已经不只是模型能力,也不是单纯节省 Token,而是减少人与 AI 之间不必要的来回沟通。
以前我们习惯把 AI 当成一个更快的程序员:给需求、写代码、Review、修改。
但当 Agent 可以读代码、调用工具、修改项目、运行测试之后,它更像一个真正参与项目的协作者。这个时候,影响效率的瓶颈开始发生变化。
我现在更关注三个东西:
- AI 到底知道多少上下文;
- 人需要做多少次判断;
- 每一次人工介入,到底值不值得。
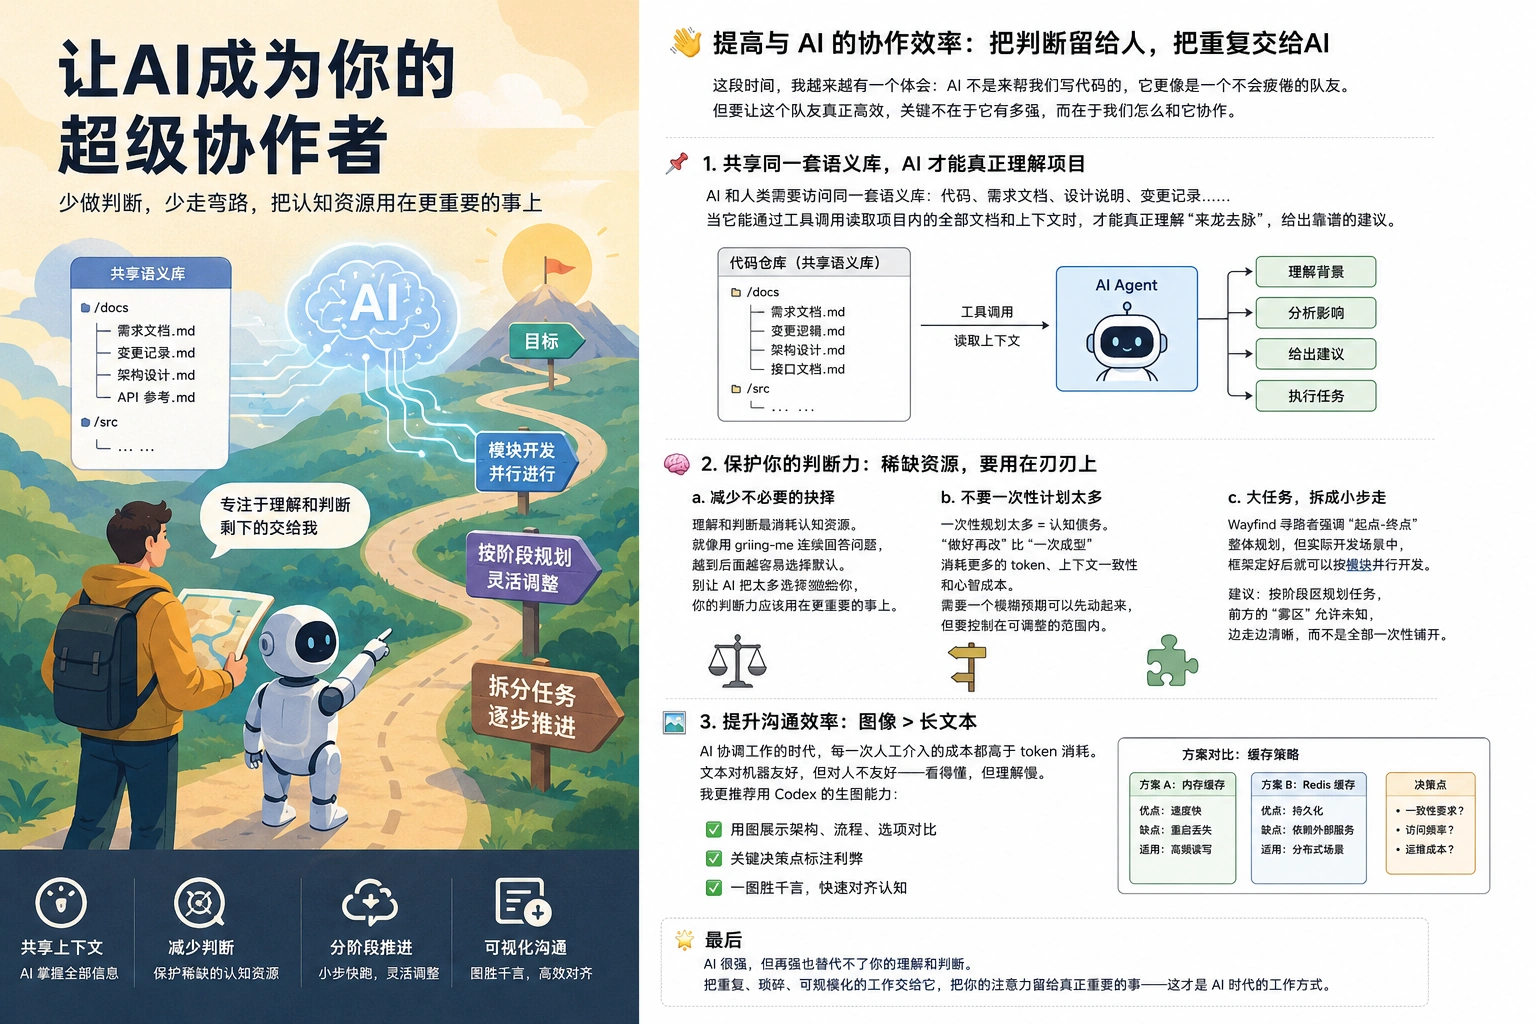
一、先解决一个基础问题:AI 和人必须共享同一套语义库
如果一个 Agent 正在参与代码仓库的开发,那么它不应该只看到代码。
需求文档、架构设计、接口说明、历史决策、变更记录、约束条件,甚至某些 ” 为什么当初没有这么做 ” 的解释,都应该成为仓库的一部分。
例如:
project/
├── docs/
│   ├── requirements/
│   ├── architecture/
│   ├── decisions/
│   ├── changes/
│   └── api/
├── src/
└── README.md
这里的重点不是目录怎么设计。
重点是:
代码仓库本身应该逐渐变成人和 Agent 共享的语义空间。
Agent 遇到问题时,应该优先通过工具调用去读取项目内部已有的信息,而不是重新问人:
这个模块为什么这么设计?
这个接口兼容哪些旧逻辑?
这次改动有没有不能碰的地方?
如果这些问题已经有人回答过一次,就不应该再消耗一次人的注意力。
否则项目越复杂,人就越容易变成 AI 的 ” 上下文 API”。
而这是非常低效的。
二、人的判断力,比 Token 更贵
这一点是我最近感受最明显的。
很多 AI 工具喜欢不断向用户确认:
- 方案 A 还是方案 B?
- 要不要增加这个功能?
- 这里是否需要兼容?
- 这个目录结构是否接受?
- 下一步是否继续?
单独看,每个问题都很合理。
问题是,当这种确认连续发生几十次之后,人会开始疲劳。
前面几个问题你可能还会认真比较,到了后面,很容易直接:
默认吧。
这时候所谓的 “Human in the Loop”,可能已经变成了 “Human Clicking Default”。
所以我现在越来越认为:
判断能力是一种稀缺的认知资源。
不应该让 AI 把所有不确定性都转嫁给人。
真正值得打断人的,应该是那些:
- 会明显影响最终方向的选择;
- 修改成本很高的决策;
- 涉及安全、数据或不可逆操作的决策;
- 不同方案存在明显业务取舍的决策。
至于大量局部实现问题,AI 完全可以基于已有上下文、项目规范和默认策略自己处理。
换句话说:
AI 的价值不只是替你写代码,还应该替你过滤掉那些根本不值得你思考的问题。
三、不要一次把整个世界规划完
另一个问题出现在 ” 大任务规划 ”。
理论上,一个复杂任务应该:
起点
 ↓
分析问题
 ↓
规划完整路线
 ↓
拆分任务
 ↓
逐项执行
 ↓
到达终点
这个模型看起来非常正确。
我在使用 Wayfind 一类 ” 寻路式 ” Skill 时,也认可它的基本思想:
给定起点和终点,中间路径由 AI 构造。
但实际做代码开发时,我慢慢发现一个问题:
很多时候,我们并不需要在开始之前看清整张地图。
软件开发本来就是不断暴露新信息的过程。
例如一个系统已经确定:
用户层
  ↓
API
  ↓
业务服务
  ↓
任务系统
  ↓
模型 / Agent
  ↓
数据层
到了这里,其实已经足够开始工作。
完全可以先做认证模块,再做任务模块,再处理 Agent Runtime。
只有真正进入某个模块之后,才需要进一步回答:
- 数据结构怎么设计?
- 状态机怎么走?
- 哪些异常需要重试?
- 是否需要幂等?
- 和其他模块有什么耦合?
这些问题在项目刚开始时强行全部确认,得到的往往只是一种 ” 看起来很完整 ” 的规划。
但它有三个成本。
第一,前期需要人连续做大量判断。
第二,很多设计会随着实现被推翻。
第三,过长的规划会不断消耗上下文,并产生新的认知债务。
所以我现在更倾向于另一种方式:
终点
  ▲

        ? ? ? ? ?
      雾区 / 未知区

--------- 当前阶段边界 ---------

   模块 C
      ▲
   模块 B
      ▲
   模块 A
      ▲
    当前
不是要求 AI 一开始画出完整路线,而是:
允许前方存在 ” 雾区 ”。
先确定:
- 大方向;
- 当前阶段目标;
- 当前模块边界;
- 最近几个可执行步骤。
完成一个阶段之后,再根据真实代码、测试结果和新暴露的问题继续规划。
这和游戏里的 ” 战争迷雾 ” 很像。
地图不是不存在,只是现在没有必要把所有地方都探索完。
四、” 做好再改 ” 并不总是便宜
AI Coding 很容易产生一个错觉:
反正 AI 改代码很快,先做出来再改就行。
局部来看没问题。
但大型任务里,” 做好再改 ” 的成本经常被低估。
因为修改不仅仅消耗生成代码的 Token。
它还包括:
- AI 重新理解旧实现;
- 新旧逻辑同时占据上下文;
- 文档和代码重新同步;
- 已经做出的决策被推翻;
- 测试重新调整;
- 人重新理解 ” 现在到底变成什么样了 ”。
也就是说,每一次大的返工都会增加项目的认知债务。
所以我并不主张 ” 所有事情都提前设计完整 ”。
相反,我认为合理的方式应该是:
大结构提前确定,局部设计延迟到真正开始实现之前。
既不要一开始把所有细节想完,也不要完全没有边界地一路生成。
五、每一次人工介入,都应该比 Token 更贵
如果未来越来越多工作由 Agent 协调,我认为会出现一个很重要的成本排序:
人的理解成本
    >
人的判断成本
    >
人的上下文切换成本
    >
Token 成本
今天大家很喜欢讨论:
- 一次任务用了多少 Token;
- Prompt 能不能再短一点;
- 缓存命中率是多少;
- 模型价格贵不贵。
这些当然重要。
但对于真正长时间使用 Agent 的人来说,另一种成本可能更加明显:
AI 每隔几分钟把你叫回来一次。
你本来在做别的事情,AI 突然问:
Redis 缓存还是本地缓存?
你需要重新进入上下文,理解两种方案,判断当前业务,然后回复。
十分钟之后:
这里是否增加降级策略?
再切回来一次。
如果一个 Agent 每完成一点工作都需要人重新 ” 加载上下文 “,那么即使它几乎不消耗 Token,也不能算高效。
真正理想的协作状态应该是:
AI 连续工作
        │
        │
        │
        ▼
遇到真正关键的分叉
        │
        ▼
人介入一次
        │
  ┌─────┴─────┐
  ▼           ▼
方案 A       方案 B

完成判断

        │
        ▼
AI 继续工作
而不是:
AI → 问人 → AI → 问人 → AI → 问人 → AI → 问人六、文本对机器友好,但不一定对人友好
这又会带来一个很有意思的问题。
Agent 最喜欢使用文本。
因为文本:
- Token 化方便;
- 精确;
- 可搜索;
- 可版本管理;
- 很容易放进上下文。
但对人来说,长文本并不是最高效的信息载体。
特别是在需要理解:
- 系统架构;
- 模块关系;
- 数据流;
- 状态变化;
- 两个方案之间的差异;
这些问题时,一张图通常比几千字更快。
所以我现在越来越希望 AI 在需要我做重要判断时,不要只给我这样的内容:
方案 A:
优点……
缺点……

方案 B:
优点……
缺点……
而是直接给我一张图:
                  当前系统

                     │
            ┌────────┴────────┐
            │                 │
         方案 A             方案 B
       内存缓存             Redis
            │                 │
       延迟更低             可共享
       单机状态             多实例
       重启丢失             运维成本
            │                 │
            └────────┬────────┘
                     │
                   决策点
甚至进一步直接生成正式图片,把:
- 当前架构;
- 修改后的架构;
- 影响范围;
- 两种方案的区别;
- 需要我判断的那个点;
全部画出来。
我目前很喜欢 Codex 里这类生图能力的使用方式:
不是为了做漂亮的图,而是为了减少人与 AI 之间的信息压缩损耗。
因为 ” 看懂一段文字 ” 和 ” 真正建立脑中的结构 ” 并不是一回事。
七、我现在更期待的 Agent 协作方式
如果把上面的想法合起来,我希望未来的 Agent 更像这样工作:
1. 默认自己读取上下文
代码、需求、架构、历史决策和变更记录,都先从项目内部读取。
已经存在的信息,不再问人。
2. 默认自己处理低风险决策
命名、局部实现、代码组织、普通错误处理等问题,按照项目约定自主完成。
不要把选择题全部丢给用户。
3. 大任务分阶段,而不是一次规划到底
知道终点即可。
前方允许存在雾区。
先规划最近的一段路,到阶段节点后再重新规划。
4. 只有真正重要的分叉才要求人工判断
把几十次确认压缩成几次高价值确认。
5. 需要人理解时,优先可视化
如果一个问题需要我在脑中重新构建系统结构,那么 AI 最好直接给我结构图、流程图或者方案对比图。
文字负责精确。
图负责理解。
最后
AI 越强,人越不应该成为流水线上的确认按钮。
真正好的 Agent,不应该不断证明 ” 我什么都会问你 ”。
而应该逐渐知道:
什么事情可以自己决定,什么事情值得占用你的注意力。
所以我现在理解的 ” 提高与 AI 的协作效率 “,已经不再只是 Prompt 写得更好、模型选得更强或者 Token 用得更少。
而是三件事:
让 AI 掌握足够完整的上下文。
让人只参与真正重要的判断。
让复杂信息以人更容易理解的方式出现。
最终我们优化的并不是一次模型调用。
而是人与 AI 之间那条越来越长的协作链路。