最近处理了一个 ClickHouse 跨版本数据同步的问题:19.x 与 25.x 两套环境之间,需要迁移和补齐一批监控指标数据。
一开始它看起来只是个 ” 数据搬运 ” 问题。但随着数据量上来,很快撞上了两个很典型的坑:
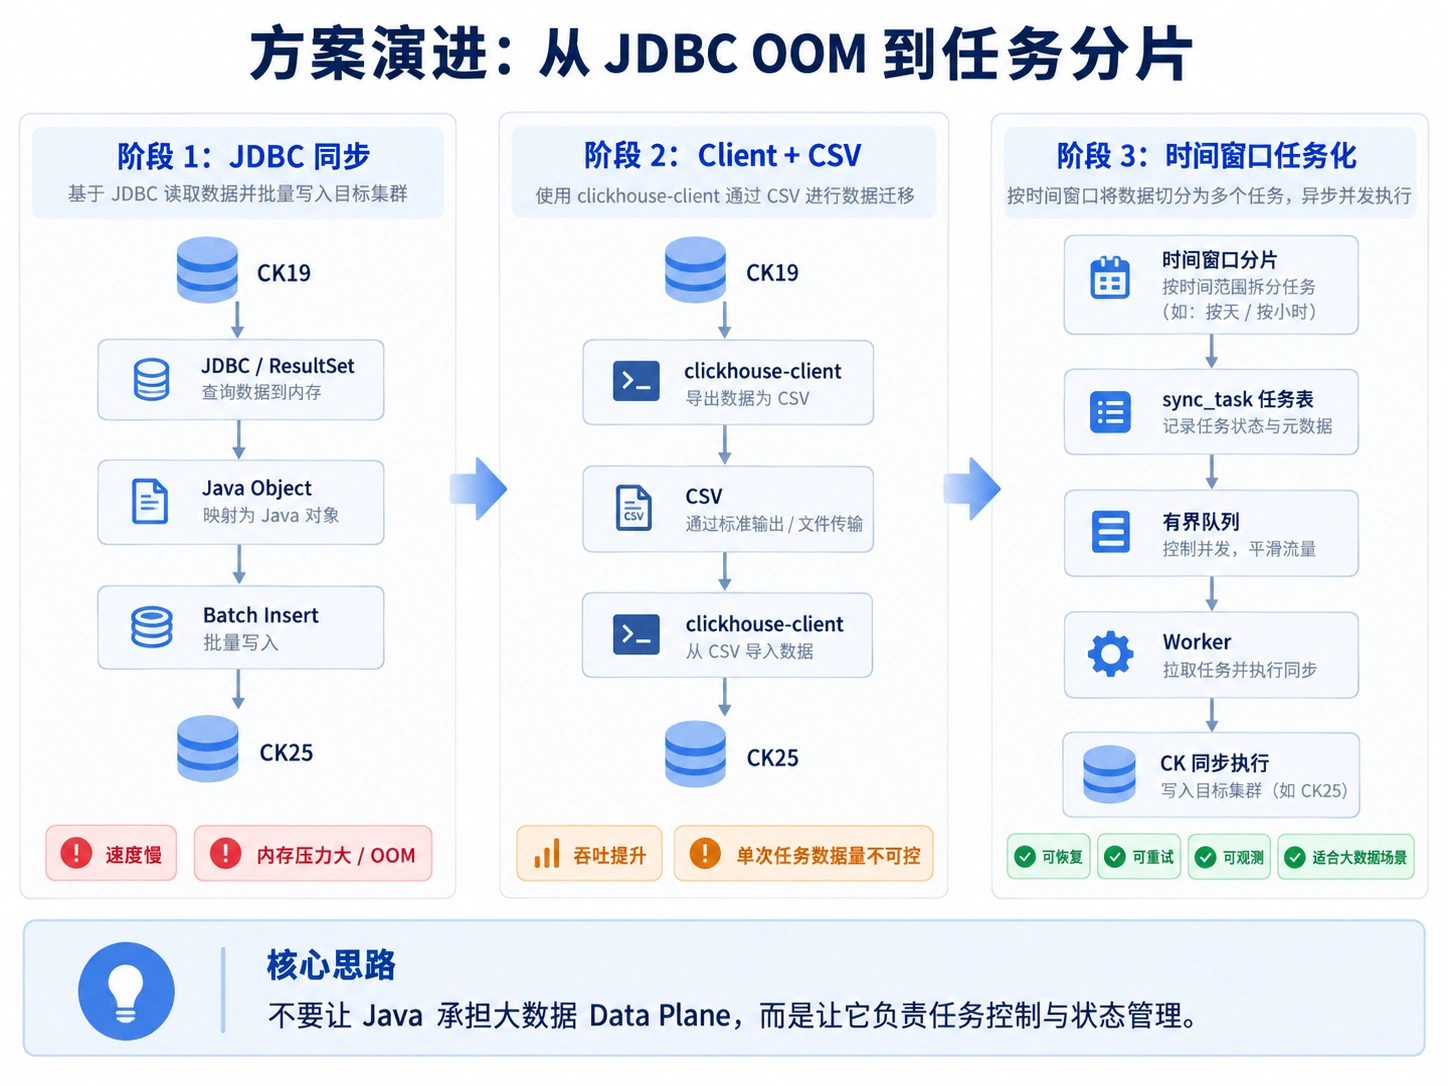
- Spring Boot 走 JDBC 读数据 → 转成 Java 对象 → 批量写入,速度慢,JVM 内存压力很大,甚至直接 OOM;
- 改用 clickhouse-client 导出 CSV 后,吞吐明显上去了,但单次任务的数据范围太大,文件大小难以控制,一旦失败,重跑成本极高。
真正让方案定型的,是思路上的一次转变——从:
怎么让一次大数据同步跑得更快?
变成:
怎么把一次不可控的大任务,拆解成可控制、可恢复、可观察的小任务?
本文要点:
- 一致性级别要匹配业务价值,监控数据没必要为 Exactly-Once 付出复杂代价;
- Java 应该退出数据面(Data Plane),只承担控制面(Control Plane);
- 用时间窗口做分片,
[start, end)左闭右开保证窗口无缝衔接; - 任务状态落库,让同步生命周期和 JVM 生命周期解耦;
- 跨版本同步必须显式列名,不能依赖
SELECT *和字段顺序; - 失败后做窗口级重放,而不是逐行 Checkpoint。
目录:
- 一、先确定业务真正需要什么级别的一致性
- 二、为什么最开始的 JDBC 方案会遇到瓶颈
- 三、使用 clickhouse-client 后,问题发生了变化
- 四、按照时间窗口拆分同步任务
- 五、任务表同时承担分片和状态管理
- 六、数据库保存全部任务,内存只保存近期任务
- 七、任务状态需要能够避免无意义的重复调度
- 八、跨版本同步为什么需要显式指定字段
- 九、动态 SQL 的核心应该是同步模型,而不是字符串拼接
- 十、为什么失败后选择整个窗口重试
- 十一、如果一致性要求继续提高,方案应该怎么演进
- 十二、最终架构:Java 只做控制面
- 十三、这次设计中的几个关键取舍
- 十四、后续还可以优化的方向
一、先确定业务真正需要什么级别的一致性
在设计同步方案之前,先确认数据本身的业务属性。
监控指标数据和订单、支付这类业务数据有明显区别:
- 数据量大;
- 主要按时间范围查询;
- 没有业务主键;
- 单条数据的重要程度相对较低;
- 少量重复可以接受;
- 相比少量重复,更需要避免大范围数据缺失。
因此这个场景没必要为了严格的 Exactly-Once 去引入复杂的事务、逐行幂等和去重逻辑。
最终选择的目标更接近:
At-Least-Once
+
最终近似一致展开来说就是:允许少量重复;尽量避免大量数据缺失;不要求逐行事务、逐行去重、严格 Exactly-Once。
举个例子:一个时间窗口的数据已经写入 70%,随后任务异常。重新执行整个窗口,会导致前面那 70% 再写一遍——但对于监控场景,这个代价是可以接受的。相比建立精确到每一行的 Checkpoint,直接做窗口级重试,系统要简单得多。
这里最重要的一个认识是:
数据同步方案的一致性级别应该匹配业务价值,而不是默认追求最高级别的一致性。
二、为什么最开始的 JDBC 方案会遇到瓶颈
最初的方案比较直接:
ClickHouse 19.x
      ↓
     JDBC
      ↓
  ResultSet
      ↓
 Java Object
      ↓
Batch Insert
      ↓
ClickHouse 25.x
这种方式在程序控制上很方便:分页、Batch Size、异常处理、重试都可以直接管理。但数据量变大以后,问题就暴露了。
ClickHouse 内部是列式存储的,进入 Java 后却经历了这样一条链路:
ClickHouse Column
      ↓
  ResultSet
      ↓
 Java Object
      ↓
String / Long / Date ...
      ↓
  Collection
      ↓
PreparedStatement
      ↓
再次编码写入 ClickHouse
整个过程中可能同时存在多份数据副本:JDBC Buffer、ResultSet、Java Object、Collection、Batch Buffer。如果生产速度超过消费速度,还会继续在 JVM 堆里积压。
于是即便不断调整 -Xmx、fetchSize、batchSize,也只是缓解症状。
真正的问题是:
Java 应用正在承担大数据的数据通道。
而这个场景里,Java 更适合做任务控制,而不是把海量 ClickHouse 数据转成对象后再搬运一遍。
三、使用 clickhouse-client 后,问题发生了变化
后面改成让 clickhouse-client 负责真正的数据搬运:
CK19
  ↓
clickhouse-client
  ↓
  CSV
  ↓
clickhouse-client
  ↓
CK25
性能明显好于 JDBC 方案。原因也很直接——ResultSet → POJO → PreparedStatement 这一整套 Java 对象转换被绕开了。
这也验证了前面的判断:
数据面应该尽量交给 ClickHouse 自身处理,Java 主要负责控制面。
但新的问题随之出现。如果一次查询覆盖一个很大的时间范围:
SELECT ...
FROM metric_table
WHERE ...
FORMAT CSV
就可能一次生成几十 GB 甚至更大的数据。假设一个 300 GB 的同步任务执行到 90% 后失败,而没有更细粒度的状态记录,那就只能从头再来。
所以真正需要控制的并不是:
一个 CSV 文件最多多大。
而应该是:
一个同步任务最多负责多大的数据范围。
这也是最终引入任务分片的原因。
四、按照时间窗口拆分同步任务
监控数据天然具有时间属性,因此选择时间作为主要任务边界。
例如原来需要同步 09-01 00:00 ~ 09-10 00:00,可以拆成:
Task 1    09-01 00:00 ~ 09-01 01:00
Task 2    09-01 01:00 ~ 09-01 02:00
Task 3    09-01 02:00 ~ 09-01 03:00
...
时间条件统一采用左闭右开:
time >= startTime AND time < endTime这样连续窗口可以自然首尾连接:
[00:00, 01:00)
[01:00, 02:00)
[02:00, 03:00)
不会因为边界条件出现人为的数据重叠或遗漏。
当然,不同时间窗口的数据量不一定一致,比如 03:00 有 500 万条、10:00 有 3000 万条、20:00 有 8000 万条。所以这里控制的是一个可接受的逻辑范围,而不是严格保证每个任务的数据条数相同。后续如果数据分布差异进一步扩大,可以根据历史数据量动态调整窗口大小。
五、任务表同时承担分片和状态管理
任务拆分以后,我没有直接把所有任务一次性塞进线程池,而是建立任务表持久化整个同步过程。
注意:时间窗口字段和执行时间字段同名会踩坑,下面用
window_start / window_end表示窗口,用exec_start / exec_finish表示执行时间。
CREATE TABLE sync_task (
    id              BIGINT PRIMARY KEY AUTO_INCREMENT,
    source_cluster  VARCHAR(64)  NOT NULL,
    target_cluster  VARCHAR(64)  NOT NULL,
    database_name   VARCHAR(128) NOT NULL,
    table_name      VARCHAR(128) NOT NULL,

    window_start    DATETIME     NOT NULL,   -- 数据时间窗口 [start, end)
    window_end      DATETIME     NOT NULL,

    status          VARCHAR(16)  NOT NULL,
    retry_count     INT          NOT NULL DEFAULT 0,
    worker_id       VARCHAR(64),
    lease_until     DATETIME,

    create_time     DATETIME     NOT NULL,
    exec_start      DATETIME,
    exec_finish     DATETIME,
    error_message   VARCHAR(2000),

    INDEX idx_status_time (status, window_start)
);
任务状态流转:
WAITING → QUEUED → RUNNING → SUCCESS
                ↘
                FAILED → WAITING / RETRY
这样一个大型同步任务就不再依赖某一次 Java 进程的生命周期。即使发生 JVM 退出、服务重启、机器故障、网络异常、ClickHouse 暂时不可用,数据库中的任务状态依然存在,程序重启后可以继续执行尚未完成的任务。
这一步实际上把程序生命周期和同步任务生命周期分离开了。
六、数据库保存全部任务,内存只保存近期任务
如果同步范围很大,最终可能产生几十万甚至更多的任务。如果启动时一次性全部加载:
数据库几十万任务 → 全部加载 → Java QueueJava 又会重新承担大量不必要的状态。
因此设计是:
数据库    持久化完整任务
  ↓
Queue     只保存即将执行的任务
  ↓
Worker    消费任务
通过定时任务观察全局队列,例如 Queue < 200 时,再从任务表拉取一批未完成任务补进来。数据库是完整任务池,Java Queue 只是短期执行缓冲区。
后续还可以进一步改成低水位 + 高水位模式:
Queue < 200  → 开始补充
补充到 500   → 停止拉取
避免队列一低于阈值就持续触发数据库查询。同时 Queue 本身应该保持有界,避免生产速度失控再次造成内存问题。
七、任务状态需要能够避免无意义的重复调度
业务允许少量数据重复,并不意味着调度层可以随意重复执行同一个任务。
假设未来部署多个 Worker:
Worker A ┐
         ├→ 查询 WAITING
Worker B ┘
如果没有任务抢占机制,两个 Worker 可能同时执行同一个时间窗口。因此任务从数据库进入 Queue 时,应该先做状态变更(WAITING → QUEUED),并保证领取过程具有原子性:
-- 抢占式领取:利用行锁保证同一个任务只被一个 Worker 拿到
UPDATE sync_task
   SET status      = 'QUEUED',
       worker_id   = ?,
       lease_until = DATE_ADD(NOW(), INTERVAL 300 SECOND)
 WHERE status      = 'WAITING'
 ORDER BY window_start
 LIMIT 100;
进一步可以增加 worker_id、lease_until、心跳等机制,支持租约式任务执行。
这里需要区分两种重复:
异常重试导致的数据重复     ← 业务主动接受的一致性取舍
调度系统缺陷导致的数据重复 ← 应该尽量避免
前者是主动选择,后者是系统缺陷。
八、跨版本同步为什么需要显式指定字段
这个场景还有一个比较特殊的问题:两边分别是 ClickHouse 19.x 和 25.x,版本跨度较大,而且同步方向既可能是 CK19 → CK25,也可能是 CK25 → CK19。
因此同步程序不能简单地把源端、目标端和 SQL 固定下来,同时也不能过度依赖 SELECT *——不同版本、不同表定义中可能存在特殊列或字段差异。如果依赖字段数量和字段顺序来写入,跨版本场景下风险会比较高。
所以实际采用显式字段:
SELECT
    timestamp,
    host,
    metric_name,
    metric_value,
    tags
FROM xxx
WHERE timestamp >= ?
  AND timestamp < ?
目标端写入同样指定字段:
INSERT INTO xxx (
    timestamp,
    host,
    metric_name,
    metric_value,
    tags
)
真正建立的是:
Column Name → Column Name而不是:
Column Position → Column Position同步方向、数据库、表名、时间字段、同步字段等都由配置提供。因此单个任务执行时只有一条链路:Source → Time Window → Target。框架可以支持两个方向,但一个具体任务始终保持单向执行。
九、动态 SQL 的核心应该是同步模型,而不是字符串拼接
由于不同表、不同方向需要动态生成 SQL,很容易最终写成大量字符串拼接:
"SELECT " + columns + " FROM " + table + " WHERE " + condition如果后续要增加字段兼容逻辑,这种代码会越来越难维护。更合理的是先定义同步配置:
public record SyncConfig(
    String  sourceCluster,
    String  targetCluster,
    String  database,
    String  table,
    String  timeColumn,
    List<String> columns,
    Duration windowSize,
    Direction direction   // CK19_TO_CK25 | CK25_TO_CK19
) {}
执行时:
SyncConfig + SyncTask → SQL Builder → Executable SQL这样未来即使增加字段映射、字段排除、CAST 转换、表名映射、特殊类型转换,主要变化也集中在 SQL Builder,而不会污染任务调度逻辑。
十、为什么失败后选择整个窗口重试
传统业务系统在部分成功后,通常会考虑记录最后一个成功位置:offset、primary key、sequence。
但当前监控数据没有业务主键,同时允许少量重复。因此没有继续构造 Row-Level Checkpoint,而是采用 Window-Level Recovery:
01:00 ~ 02:00 这个任务失败 → 重新执行 01:00 ~ 02:00而不是继续追踪 ” 已经成功到了具体哪一行 ”。
这实际上是在利用业务允许重复的特性,主动降低恢复机制的复杂度。
十一、如果一致性要求继续提高,方案应该怎么演进
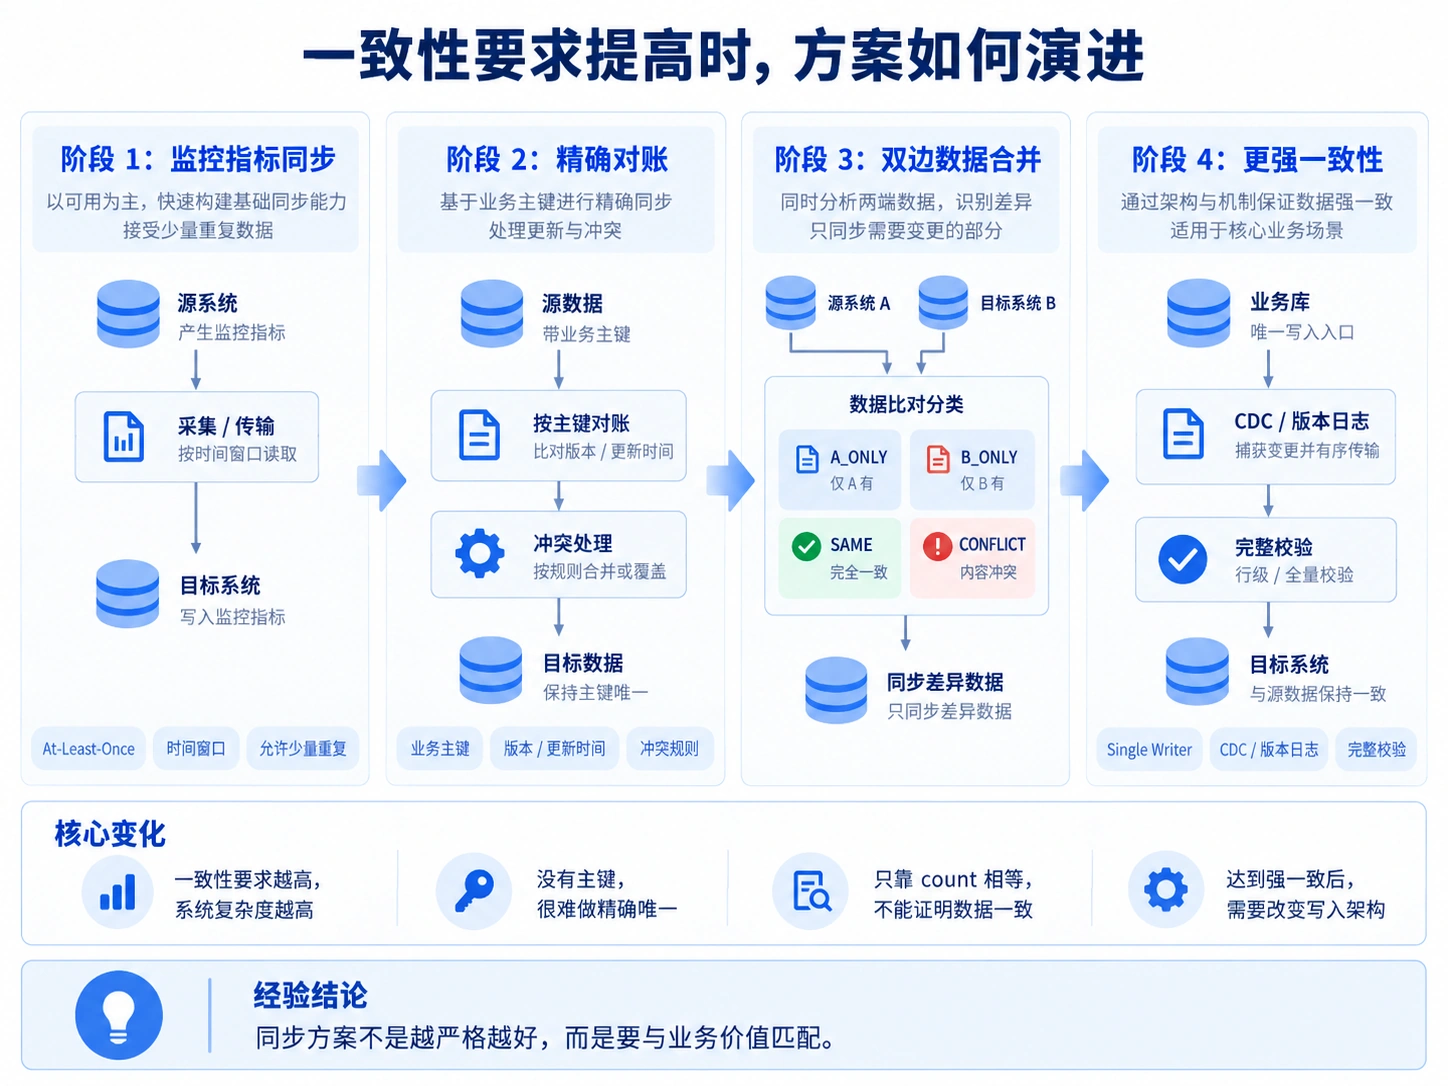
当前方案是针对监控指标数据设计的。但设计过程中,我也顺带考虑了两类更复杂的场景。
1. 如果两边都有数据,需要进行真正的数据合并
假设两边都有相同主键的数据,首先必须提前定义确定性的冲突规则:
有 version:                version 大的为准
没有 version:              update_time 新的为准
version、update_time 都无法判断:按配置指定某一侧为权威数据源
同步程序只执行已经定义好的规则,而不是运行过程中再交给开发人员人工判断。
对于大数据量,也没必要一开始就对两边全部数据做逐行比较,可以继续沿用分片思路:
时间窗口 + Hash(PK) 分桶先比较每个桶的数据量、唯一主键数量以及数据摘要;只有摘要不一致的 Bucket,再提取 PK / version / update_time / row hash 进一步比较;最后只读取和写入真正存在差异的数据:
粗粒度摘要比较 → 发现差异 Bucket → PK 级比较 → 只同步差异数据这样可以避免亿级数据每次都做完整 JOIN。
2. 如果要求最终严格唯一、完全一致
如果业务要求 ” 一条不少、一条不多、同一个业务主键只有一条、两边内容完全相同 “,那么当前允许重复的 At-Least-Once 方案就不够了。这时首先必须存在稳定的业务唯一键。
最终校验也不能只比较 count(A) == count(B),因为 A = {1,2,3} 和 B = {1,2,4} 数量都是 3,但数据并不一致。更完整的校验至少应该包含三层:
count == unique PK count——保证单边不存在重复主键;A_ONLY = 0且B_ONLY = 0——保证双方主键集合一致;- 相同 PK 对应的数据内容一致。
即 数量一致 + 主键集合一致 + 数据内容一致,才能认为这个时间窗口真正完成精确对账。
这里更准确的说法是 ” 最终精确一致 “。如果要求任意时刻两边读取结果都完全一致,那么单纯依赖异步同步任务无法提供保证,需要进一步改变写入架构。
这也是设计过程中比较重要的一个认识:
随着一致性要求提高,不应该只是在原同步程序上不断增加逻辑;达到一定程度后,数据模型和同步架构本身都需要发生变化。
十二、最终架构:Java 只做控制面
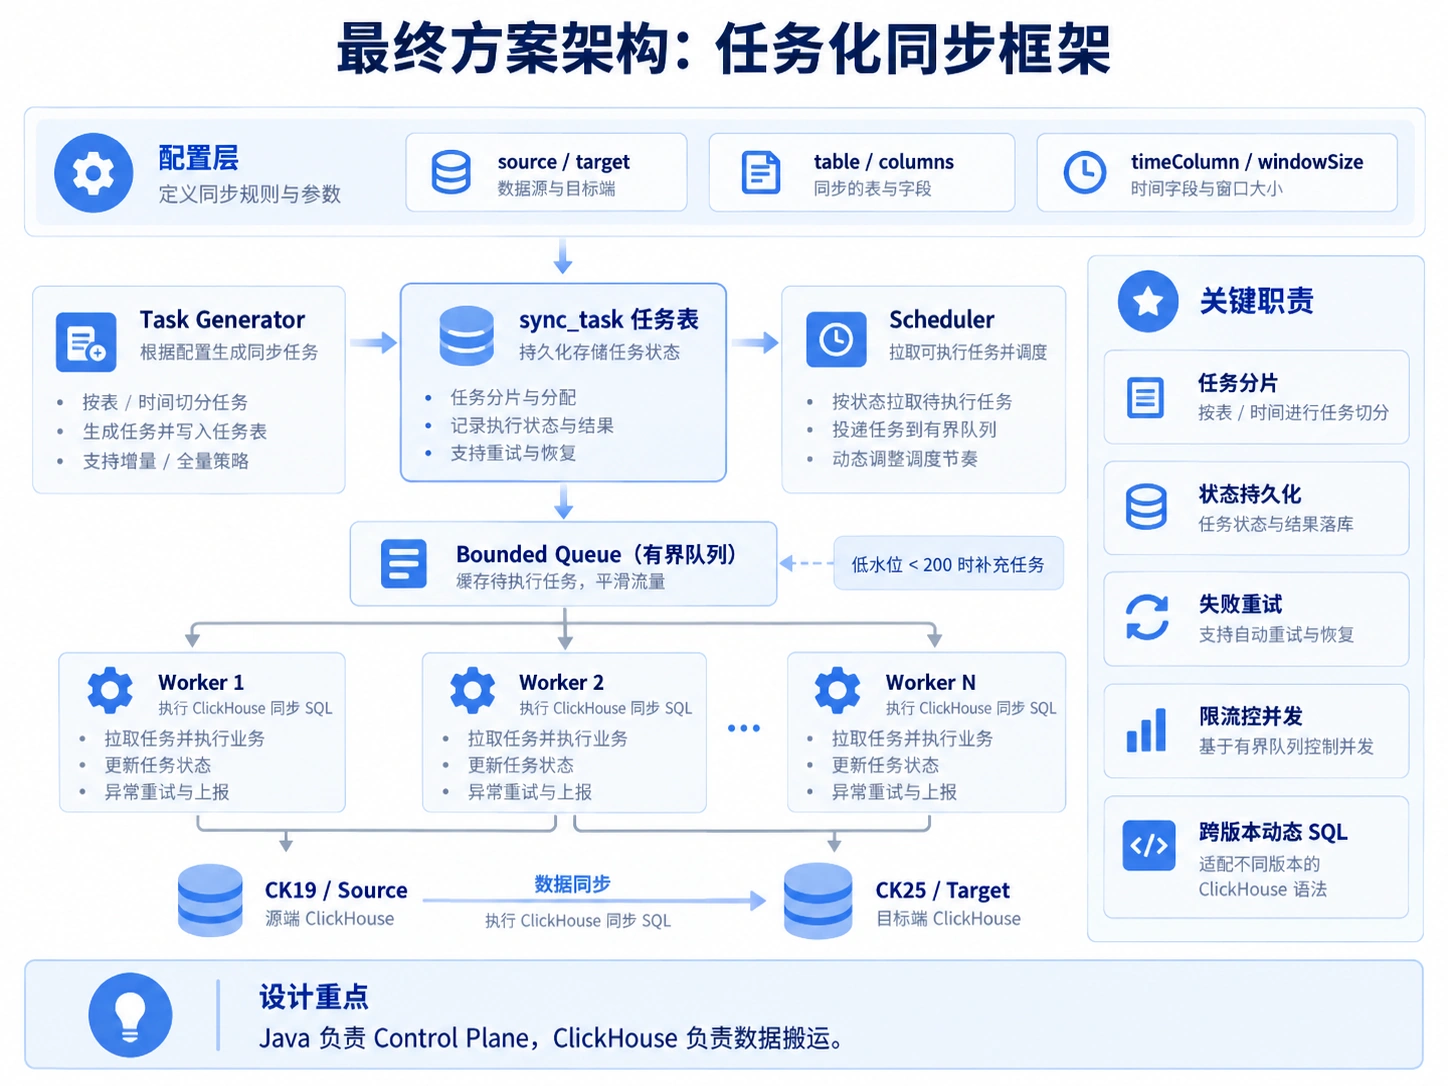
回过头看,最开始的问题只是 ” 怎么把 CK19 数据同步到 CK25”,但最终真正处理的是:大任务怎么拆分、任务状态怎么持久化、如何避免 JVM 承载大量数据、服务重启后怎么恢复、任务失败怎么重试、内存队列怎么限制、跨版本字段怎么兼容、双向能力怎么配置、不同一致性要求怎么演进。
最终的整体结构更接近:
                  Java Control Plane
                         │
             ┌───────────┴───────────┐
             │                       │
       Task Generator            Scheduler
             │                       │
             ▼                       ▼
        sync_task DB           Bounded Queue
                                      │
                                      ▼
                                 Worker Pool
                                      │
                                 Dynamic SQL
                                      │
                        ┌─────────────┴─────────────┐
                        ▼                           ▼
                      CK19                         CK25
Java 主要负责:拆任务、管理任务、调度任务、重试任务、生成 SQL、记录状态;而不再负责把海量 ClickHouse 数据加载进 JVM。
十三、这次设计中的几个关键取舍
整个方案并没有追求一个理论上最复杂、最严格的数据同步系统,而是围绕当前业务做了几个明确取舍:
| 维度 | 放弃 | 选择 |
|---|---|---|
| 一致性 | Exactly-Once | At-Least-Once |
| 恢复粒度 | Row-Level Checkpoint | Time-Window Checkpoint |
| 数据处理 | Java 承担 Data Plane | Java 只做 Control Plane |
| 任务状态 | 全量驻留内存 | 完整状态落库,JVM 只存近期任务 |
| 流量控制 | 无界队列 | 有界 Queue + 低水位补充 |
| 跨版本 | SELECT * | 显式维护字段集合 |
| 同步方向 | 固定单向 | 框架双向,单任务单向 |
这些选择背后其实是同一个原则:
先确定业务真正需要保证什么,再决定技术需要做到什么。
如果业务对象从监控指标变成订单、账户或支付数据,那么一致性模型、任务恢复方式以及最终校验机制都会相应改变。
十四、后续还可以优化的方向
目前这套方案已经能解决主要问题,但还有几个比较明确的演进方向:
- 队列水位:从单一阈值
queue.size < 200升级成 Low Watermark + High Watermark,减少数据库轮询; - 租约与心跳:增加
workerId、leaseExpireTime、heartbeat,增强多实例执行时的任务抢占和故障恢复; - 动态分片:任务时间窗口从固定长度演进成动态分片——历史数据量小则扩大窗口,历史数据量大则缩小窗口;
- 轻量校验:即使当前业务不要求严格一致,也可以记录
sourceCount、targetCount、时间范围和统计指标,用来发现明显的数据同步异常。
总结
这次 ClickHouse 19.x 与 25.x 数据同步,最开始暴露的是几个非常具体的问题:JDBC 慢、JVM OOM、CSV 数据量过大。
如果只针对这些表面问题继续优化,很容易陷入:继续加 JVM 内存、继续调 fetchSize、继续调 batchSize、继续优化单次 SQL。
但最终的解法不是继续强化一次执行,而是改变整个问题的粒度——
一次不可控的大数据同步 → 大量可以独立管理的小任务再通过时间窗口分片、任务状态持久化、有界任务队列、失败窗口重试、动态 SQL、显式字段映射,把整个过程变成一个可控制、可恢复的数据同步系统。
这次实践中我认为最重要的两个认识:
第一:
大数据场景下,当一次执行已经变得不可控时,与其继续优化一次执行,不如先把问题拆成可控制的执行单元。
第二:
同步系统需要提供多强的一致性,本质上首先是业务问题。监控数据可以接受 At-Least-Once,而严格唯一的数据则需要进一步引入业务主键、冲突规则、数据对账和完整校验。
先明确业务可以接受什么,再决定技术必须保证什么,通常比直接追求最高级别的一致性更重要。