最近我一直在用 Kimi 跑编码工作流。最开始并没有特别关注 Token,只是有一个很直接的感受:199 元套餐的周额度,怎么掉得这么快?
直到这次额度明显不够用,我才认真把其中一段真实使用记录拆开看。
结果比我预想的更有意思。
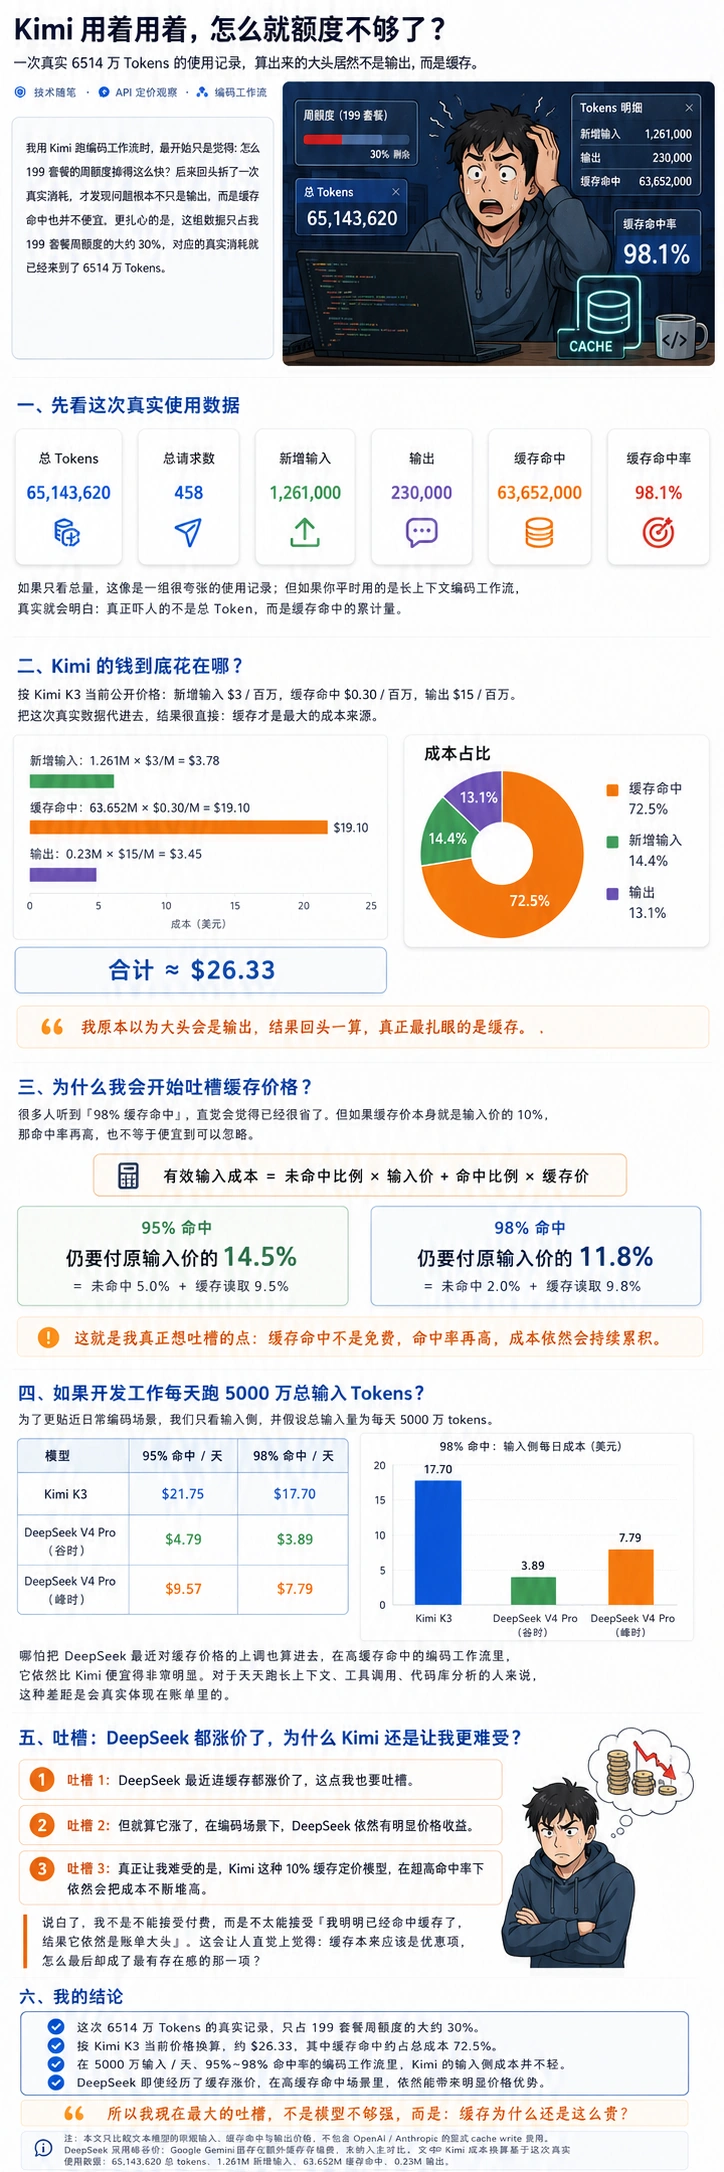
这次记录只消耗了 199 套餐大约 30% 的周额度,但后台统计到的真实 Token 消耗已经达到:
65,143,620 Tokens,约 6514 万。
我原本以为,编码 Agent 成本的大头应该是模型输出。真正算完后才发现:不是输出,而是缓存。
一、先看这次真实使用数据
这组数据来自一次实际的 Kimi 编码工作流:
| 指标 | 数值 |
|---|---|
| 总 Tokens | 65,143,620 |
| 总请求数 | 458 |
| 新增输入 | 1,261,000 |
| 输出 | 230,000 |
| 缓存命中 | 63,652,000 |
| 缓存命中率 | 98.1% |
单看 6514 万 Tokens 会觉得非常夸张,但拆开以后会发现一个非常典型的 Coding Agent 特征:
新增输入其实并不多,绝大多数 Token 都来自历史上下文的缓存读取。
新增输入只有约 126 万,而缓存命中高达 6365 万。
也就是说,在长上下文、代码库分析、工具调用、多轮 Agent 工作流里,真正决定长期成本的往往已经不是 ” 每次又输入了多少新文字 “,而是:
模型每一轮到底要重新读取多少上下文,以及读取缓存到底收费多少。
二、Kimi K3 的钱到底花在哪里?
按目前 Kimi K3 官方公开 API 定价:
- 缓存未命中输入:$3 / 1M Tokens
- 缓存命中输入:$0.30 / 1M Tokens
- 输出:$15 / 1M Tokens
把我这次真实数据代进去:
新增输入
1.261M × $3/M ≈ $3.78缓存命中
63.652M × $0.30/M ≈ $19.10输出
0.23M × $15/M ≈ $3.45最终合计大约:
$26.33
其中最让我意外的是成本占比:
| 成本来源 | 费用 | 占比 |
|---|---|---|
| 缓存命中 | $19.10 | 约 72.5% |
| 新增输入 | $3.78 | 约 14.4% |
| 输出 | $3.45 | 约 13.1% |
也就是说,我这次真正花钱最多的,不是模型生成代码,也不是新增 Prompt,而是:
读取已经缓存过的上下文。
这就是我开始觉得缓存定价有点微妙的地方。
三、98% 缓存命中,真的已经很便宜了吗?
看到 98.1% 缓存命中率,第一反应很容易是:那应该已经非常省钱了。
但问题在于,Kimi 的缓存命中价格本身仍然是普通输入价格的 10%。
假设一个模型:
普通输入价格 = 1
缓存读取价格 = 0.1
那么在 95% 缓存命中率下:
5% × 1 + 95% × 0.1
= 0.05 + 0.095
= 0.145
也就是即使 95% 命中缓存,输入侧依然需要支付原始输入价格的:
14.5%
98% 命中时:
2% × 1 + 98% × 0.1
= 0.02 + 0.098
= 0.118
依然是:
11.8%
所以,“98% 缓存命中 ” 和 ” 输入成本只剩 2%” 完全不是一回事。
这里真正容易产生心理落差的是:我已经把缓存命中率做到了接近 100%,但每轮长上下文读取仍然会持续产生费用。
而 Coding Agent 恰恰又是一个上下文不断增长、持续复用历史信息的场景。
因此,缓存单价看起来只差几毛钱,但一旦总输入来到几千万甚至上亿 Tokens,差距就会迅速放大。
四、和其他旗舰模型放在一起看
下面这张图使用我这次整理的最新官方公开价格,对比了 Kimi、DeepSeek、Claude 和 OpenAI 模型的缓存读取成本,同时换算了 95% / 98% 缓存命中时的有效输入价格。
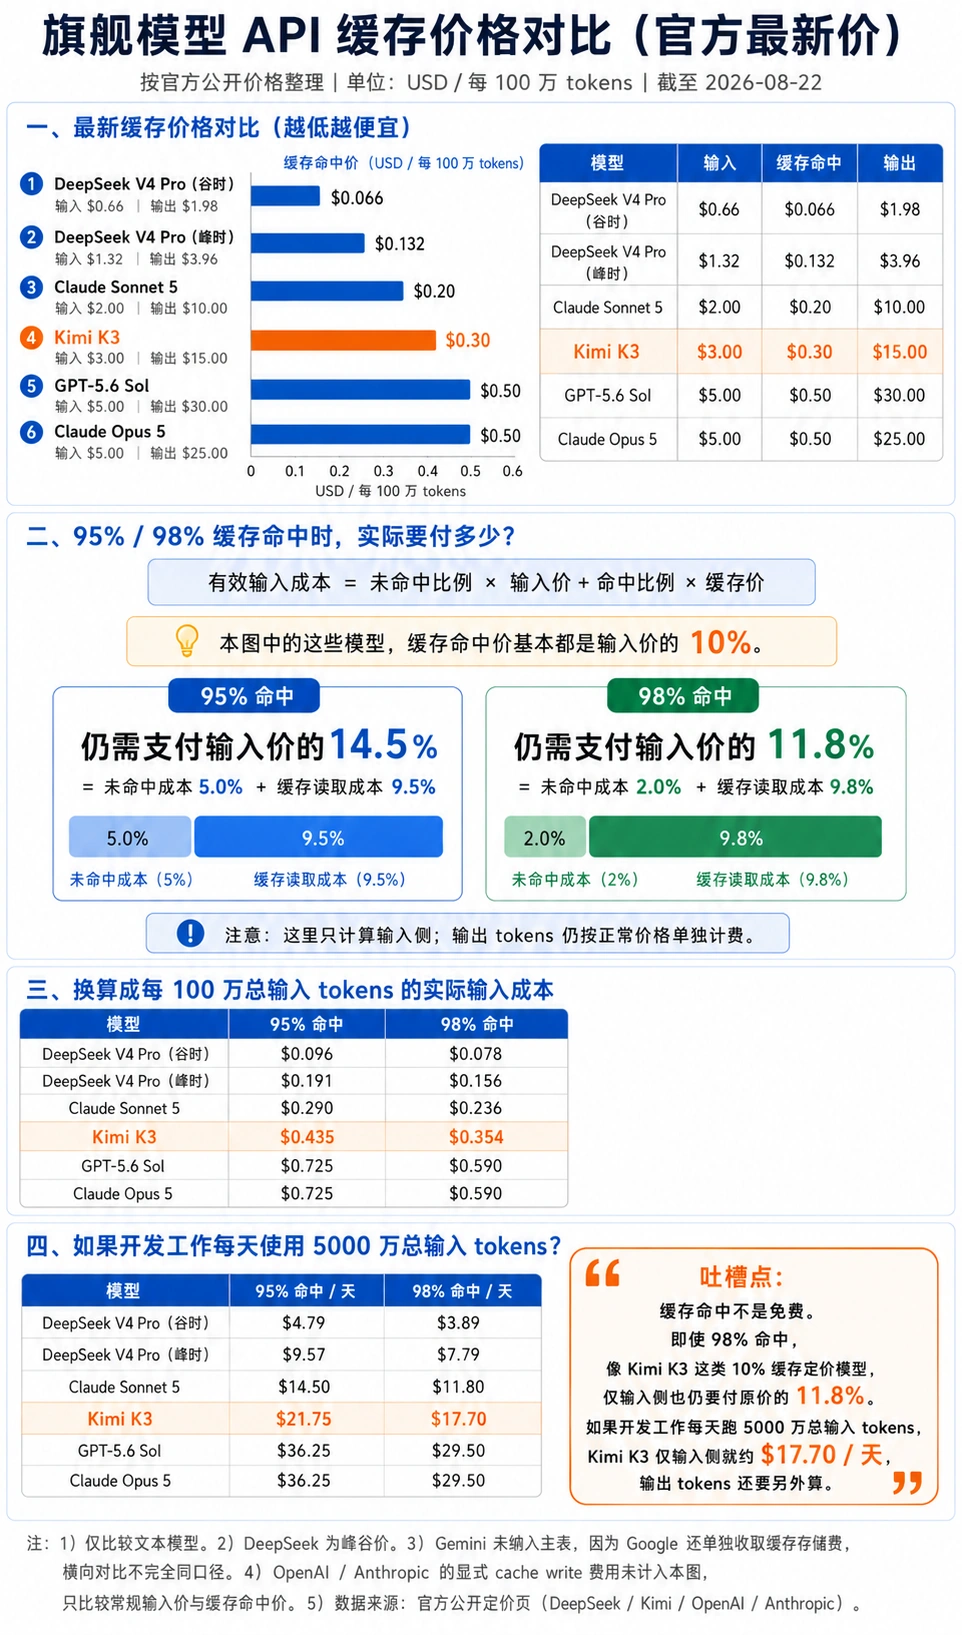
这里有一个很明显的规律:
Kimi 的 10% 缓存价并不是行业里特别离谱的规则。
OpenAI、Anthropic 等模型也大量采用类似的缓存读取折扣结构。因此如果只和这些国际旗舰模型横向比较,Kimi 的 $0.30/M 并不能简单说成异常昂贵。
但问题是:DeepSeek 把这个对比拉开了。
五、DeepSeek 缓存都涨价了,我为什么还是觉得它便宜?
这部分其实也挺值得吐槽。
DeepSeek 最近调整了 V4 Pro 的价格,而且缓存命中价格也明显上涨了。
如果只看涨幅,我同样不喜欢。
缓存本来就是 Agent 工作流里最容易形成巨大累计量的一部分,现在连这一块也涨价,对于开发者显然不是什么好消息。
但是,当我真的把价格代入每天的 Coding Agent 使用量后,又会发现一个有点尴尬的事实:
DeepSeek 虽然涨价了,但在高缓存命中的编码场景里,依然有非常明显的成本优势。
假设我的开发工作每天产生:
5000 万总输入 Tokens
并且缓存命中率保持在 95%~98%。
只计算输入侧:
| 模型 | 95% 缓存命中 | 98% 缓存命中 |
|---|---|---|
| Kimi K3 | $21.75 / 天 | $17.70 / 天 |
| DeepSeek V4 Pro(谷时) | $4.79 / 天 | $3.89 / 天 |
| DeepSeek V4 Pro(峰时) | $9.57 / 天 | $7.79 / 天 |
这里还没有计算输出 Token。
如果按 30 天计算,仅仅是输入侧,Kimi K3 在 98% 缓存命中情况下就是:
$17.70 × 30 ≈ $531 / 月而 DeepSeek V4 Pro:
谷时:$3.89 × 30 ≈ $116.7 / 月
峰时:$7.79 × 30 ≈ $233.7 / 月
对于偶尔调用 API 的应用,这种差距可能没那么敏感。
但对于每天长时间运行 Claude Code、OpenCode、DSH、各种 Agent Harness 的开发者来说,就完全不是一回事了。
因为这里不是 ” 一次请求贵几分钱 ” 的问题,而是:
每天数千万 Token × 每月几十天 × 长上下文持续读取。
在这种使用模型下,缓存价格会被无限放大。
六、所以我到底在吐槽什么?
第一,我确实想吐槽 DeepSeek。
缓存价格本来就是开发工作流里非常重要的一块,最近涨价以后,尤其对于大量长上下文 Agent 用户,成本一定会明显提高。
第二,但算完以后又不得不承认:
即使 DeepSeek 已经涨价,它在我的编码场景里依然有非常明显的价格收益。
第三,也是我这次真正产生疑问的地方:
缓存为什么要这么贵?
从基础设施角度,我当然理解缓存不是完全没有成本。
模型服务商需要维护 KV Cache、显存、存储、跨请求复用、调度以及推理基础设施。长上下文也绝对不是 ” 存在硬盘上,下次直接读取 ” 这么简单。
所以我并不认为缓存应该永久免费。
但从使用者角度,真正产生心理落差的是:
既然缓存的意义就是减少重复计算,那为什么当缓存命中率已经达到 98% 时,它仍然可以成为整张账单里最大的那一部分?
在我这次数据里:
- 新增输入:126 万
- 输出:23 万
- 缓存读取:6365 万
这意味着当 Agent 会话越来越长以后,收费模型实际上会从 ” 为新的推理和输出付费 “,逐渐变成:
为不断重新读取历史上下文付费。
这也让我开始觉得,以后判断一个模型是否适合 Coding Agent,不能再只看:
- SWE-Bench 成绩;
- 推理能力;
- 普通输入价格;
- 输出价格。
还必须增加一个非常现实的指标:
高缓存命中率下的长期有效 Token 成本。
七、199 元套餐真正让我意识到的问题
这次 6514 万 Tokens,只占我 199 元套餐大约 30% 的周额度。
从订阅角度来看,这其实说明 Kimi 的套餐本身依然给了非常高的调用价值。
如果这 30% 周额度对应约 6514 万 Token,那么按同样的工作负载简单外推,完整周额度理论上对应的 Token 规模会非常可观。
所以这篇文章并不是想说:
“Kimi 199 不值。”
恰恰相反,如果真的按 API 零售价去购买同等规模的 Token,订阅套餐依然有很明显的价值。
我真正开始关心的是另一件事:
为什么额度掉得这么快?
答案就是 Coding Agent 特有的 Token 结构。
你看到的可能只是一次代码修改、一轮 Agent 对话、一个问题。
但模型背后每轮都可能带着:
- system prompt;
- Skills;
- 工具定义;
- 项目说明;
- Git diff;
- 多个源代码文件;
- 前几轮对话;
- Agent 执行历史;
- 工具返回结果。
于是,一个看起来很简单的 ” 继续修改这个问题 “,背后可能就是十几万甚至几十万 Token 的上下文读取。
缓存把它从原价降下来了,但没有把它变成免费。
这才是核心。
八、我的结论
这次真实使用记录给我的几个结论很简单:
- **6514 万 Tokens 并不意味着真的输入了 6514 万新的内容。**绝大多数来自缓存上下文。
- Kimi K3 这次约 $26.33 的 API 等价成本里,缓存读取约占 72.5%。
- 对 Coding Agent 来说,缓存命中率只是一个指标,缓存单价同样重要。
- 95% 甚至 98% 缓存命中,并不意味着成本已经接近于零。
- 每天 5000 万级别 Token 的开发工作流下,小小的缓存单价差异会变成明显的月度成本差距。
- DeepSeek 最近缓存涨价确实值得吐槽,但即便涨价后,在高缓存命中的编码场景里依然有明显价格优势。
我现在看模型 API 定价时,会越来越关注一个过去很容易被忽略的数字:
Cached Input / Cache Hit 到底多少钱?
因为对于真正长期使用 Coding Agent 的人来说,它可能比普通 Input Price 更能决定最终账单。
最后还是那句话:
模型越来越强当然是好事,但缓存为什么还是这么贵?
数据口径说明
本文中的 Kimi 实际使用数据:
总 Tokens:65,143,620
请求数:458
新增输入:1,261,000
输出:230,000
缓存命中:63,652,000
缓存命中率:98.1%
Kimi K3 成本换算采用:
普通输入:$3 / 1M tokens
缓存命中:$0.30 / 1M tokens
输出:$15 / 1M tokens
文中的 DeepSeek 对比采用峰谷价格分别计算;为了避免不同缓存机制导致误导,本文主要讨论缓存读取 / 命中产生的长期成本,没有把所有厂商的 cache write、缓存存储费等特殊计费机制强行放进同一张表。
本文的重点不是做绝对的 ” 模型性价比排名 “。模型一次完成任务和需要多轮返工,对最终成本的影响可能远大于单纯 Token 单价。这里讨论的只是我这类高 Token、高缓存命中 Coding Agent 工作流中的一个真实成本观察。